
主题
架构设计&分布式&数据结构与算法面试题
架构设计
请列举出在 JDK 中几个常用的设计模式?
单例模式(Singleton pattern)用于 Runtime,Calendar 和其他的一些类中。工厂模式(Factory pattern)被用于各种不可变的类如 Boolean,像 Boolean.valueOf,观察者模式(Observer pattern)被用于 Swing 和很多的事件监听中。装饰器设计模式(Decorator design pattern)被用于多个 Java IO 类中。
什么是设计模式?你是否在你的代码里面使用过任何设计模式?
设计模式是软件开发人员在软件开发过程中面临的一般问题的解决方案。这些解决方案是众多软件开发人员经过相当长的一段时间的试验和错误总结出来的。设计模式是代码可用性的延伸
设计模式分类:创建型模式,结构型模式,行为型模式
静态代理、JDK 动态代理以及 CGLIB 动态代理
代理模式是 java 中最常用的设计模式之一,尤其是在 spring 框架中广泛应用。对于 java 的代理模式,一般可分为:静态代理、动态代理、以及 CGLIB 实现动态代理。
对于上述三种代理模式,分别进行说明。
静态代理
静态代理其实就是在程序运行之前,提前写好被代理方法的代理类,编译后运行。在程序运行之前,class 已经存在。
下面我们实现一个静态代理 demo:
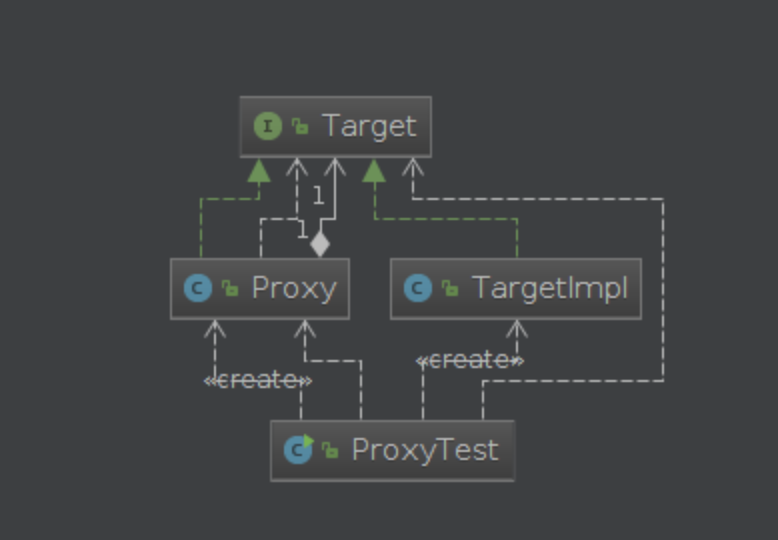
定义一个接口 Target
java
package com.test.proxy;

public interface Target {

    public String execute();
}TargetImpl 实现接口 Target
java
package com.test.proxy;

public class TargetImpl implements Target {

    @Override
    public String execute() {
        System.out.println("TargetImpl execute!");
        return "execute";
    }
}代理类
java
package com.test.proxy;

public class Proxy implements Target{

    private Target target;

    public Proxy(Target target) {
        this.target = target;
    }

    @Override
    public String execute() {
        System.out.println("perProcess");
        String result = this.target.execute();
        System.out.println("postProcess");
        return result;
    }
}测试类:
java
package com.test.proxy;

public class ProxyTest {

    public static void main(String[] args) {

        Target target = new TargetImpl();
        Proxy p = new Proxy(target);
        String result =  p.execute();
        System.out.println(result);
    }

}运行结果:
java
perProcess
TargetImpl execute!
postProcess
execute静态代理需要针对被代理的方法提前写好代理类,如果被代理的方法非常多则需要编写很多代码,因此,对于上述缺点,通过动态代理的方式进行了弥补。
动态代理
动态代理主要是通过反射机制,在运行时动态生成所需代理的 class.
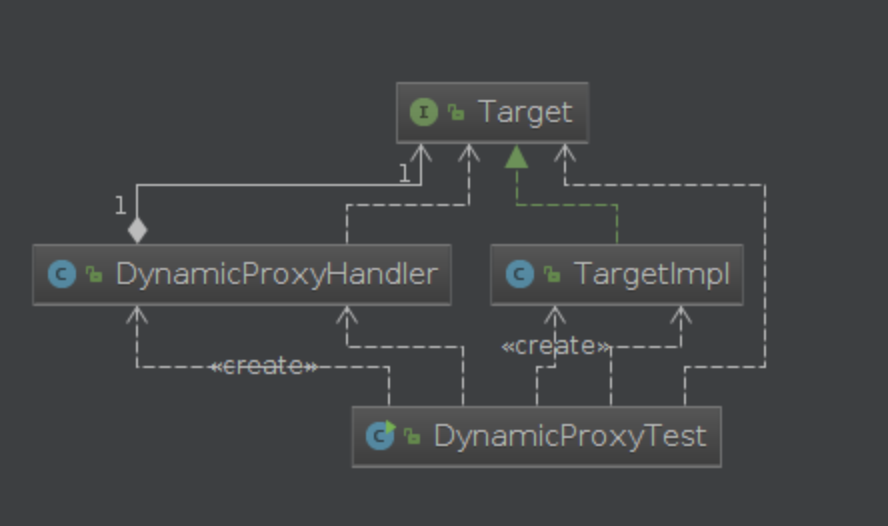
接口
java
package com.test.dynamic;

public interface Target {

    public String execute();
}实现类
java
package com.test.dynamic;

public class TargetImpl implements Target {

    @Override
    public String execute() {
        System.out.println("TargetImpl execute!");
        return "execute";
    }
}代理类
java
package com.test.dynamic;

import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;

public class DynamicProxyHandler implements InvocationHandler{

    private Target target;

    public DynamicProxyHandler(Target target) {
        this.target = target;
    }

    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        System.out.println("========before==========");
        Object result = method.invoke(target,args);
        System.out.println("========after===========");
        return result;
    }
}测试类
java
package com.test.dynamic;

import java.lang.reflect.Proxy;

public class DynamicProxyTest {

    public static void main(String[] args) {
        Target target = new TargetImpl();
        DynamicProxyHandler handler = new DynamicProxyHandler(target);
        Target proxySubject = (Target) Proxy.newProxyInstance(TargetImpl.class.getClassLoader(),TargetImpl.class.getInterfaces(),handler);
        String result = proxySubject.execute();
        System.out.println(result);
    }

}运行结果:
java
========before==========
TargetImpl execute!
========after===========
execute无论是动态代理还是静态带领,都需要定义接口,然后才能实现代理功能。这同样存在局限性,因此,为了解决这个问题,出现了第三种代理方式:cglib 代理。
cglib 代理
CGLib 采用了非常底层的字节码技术,其原理是通过字节码技术为一个类创建子类,并在子类中采用方法拦截的技术拦截所有父类方法的调用,顺势织入横切逻辑。JDK 动态代理与 CGLib 动态代理均是实现 Spring AOP 的基础。
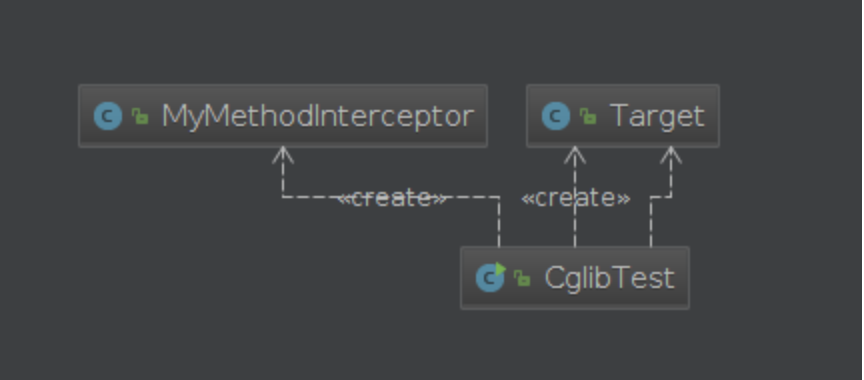
目标类
java
package com.test.cglib;

public class Target {

    public String execute() {
        String message = "-----------test------------";
        System.out.println(message);
        return message;
    }
}通用代理类
java
package com.test.cglib;

import net.sf.cglib.proxy.MethodInterceptor;
import net.sf.cglib.proxy.MethodProxy;

import java.lang.reflect.Method;

public class MyMethodInterceptor implements MethodInterceptor{

    @Override
    public Object intercept(Object obj, Method method, Object[] args, MethodProxy proxy) throws Throwable {
        System.out.println(">>>>MethodInterceptor start...");
        Object result = proxy.invokeSuper(obj,args);
        System.out.println(">>>>MethodInterceptor ending...");
        return "result";
    }
}测试类
java
package com.test.cglib;

import net.sf.cglib.proxy.Enhancer;

public class CglibTest {

    public static void main(String[] args) {
        System.out.println("***************");
        Target target = new Target();
        CglibTest test = new CglibTest();
        Target proxyTarget = (Target) test.createProxy(Target.class);
        String res = proxyTarget.execute();
        System.out.println(res);
    }

    public Object createProxy(Class targetClass) {
        Enhancer enhancer = new Enhancer();
        enhancer.setSuperclass(targetClass);
        enhancer.setCallback(new MyMethodInterceptor());
        return enhancer.create();
    }

}执行结果:
java
***************
>>>>MethodInterceptor start...
-----------test------------
>>>>MethodInterceptor ending...
result代理对象的生成过程由 Enhancer 类实现,大概步骤如下:
- 生成代理类 Class 的二进制字节码;
- 通过 Class.forName 加载二进制字节码,生成 Class 对象;
- 通过反射机制获取实例构造,并初始化代理类对象。
单例模式
单例模式(Singleton Pattern)是 Java 中最简单的设计模式之一。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。
意图:保证一个类仅有一个实例,并提供一个访问它的全局访问点。
主要解决:一个全局使用的类频繁地创建与销毁。
懒汉式,线程安全
代码实例:
java
public class Singleton2 {

    private static Singleton2 instance;

    private Singleton2() {}

    public static synchronized Singleton2 getInstance() {
        if (instance == null) {
            instance = new Singleton2();
        }

        return instance;
    }

}饿汉式,线程安全
代码实例:
java
public class Singleton3 {

    private static Singleton3 instance = new Singleton3();

    private Singleton3() {}

    public static Singleton3 getInstance() {
        return instance;
    }

}双检锁/双重校验锁 + volatile 关键字
代码实例:
java
public class Singleton7 {

    private static volatile Singleton7 instance = null;

    private Singleton7() {}

    public static Singleton7 getInstance() {
        if (instance == null) {
            synchronized (Singleton7.class) {
                if (instance == null) {
                    instance = new Singleton7();
                }
            }
        }

        return instance;
    }

}工厂模式
工厂模式(Factory Pattern)是 Java 中最常用的设计模式之一。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。
意图:定义一个创建对象的接口,让其子类自己决定实例化哪一个工厂类,工厂模式使其创建过程延迟到子类进行。
主要解决:主要解决接口选择的问题。
我们将创建一个 Shape 接口和实现 Shape 接口的实体类。下一步是定义工厂类 ShapeFactory。
FactoryPatternDemo,我们的演示类使用 ShapeFactory 来获取 Shape 对象。它将向 ShapeFactory 传递信息(CIRCLE / RECTANGLE / SQUARE),以便获取它所需对象的类型。
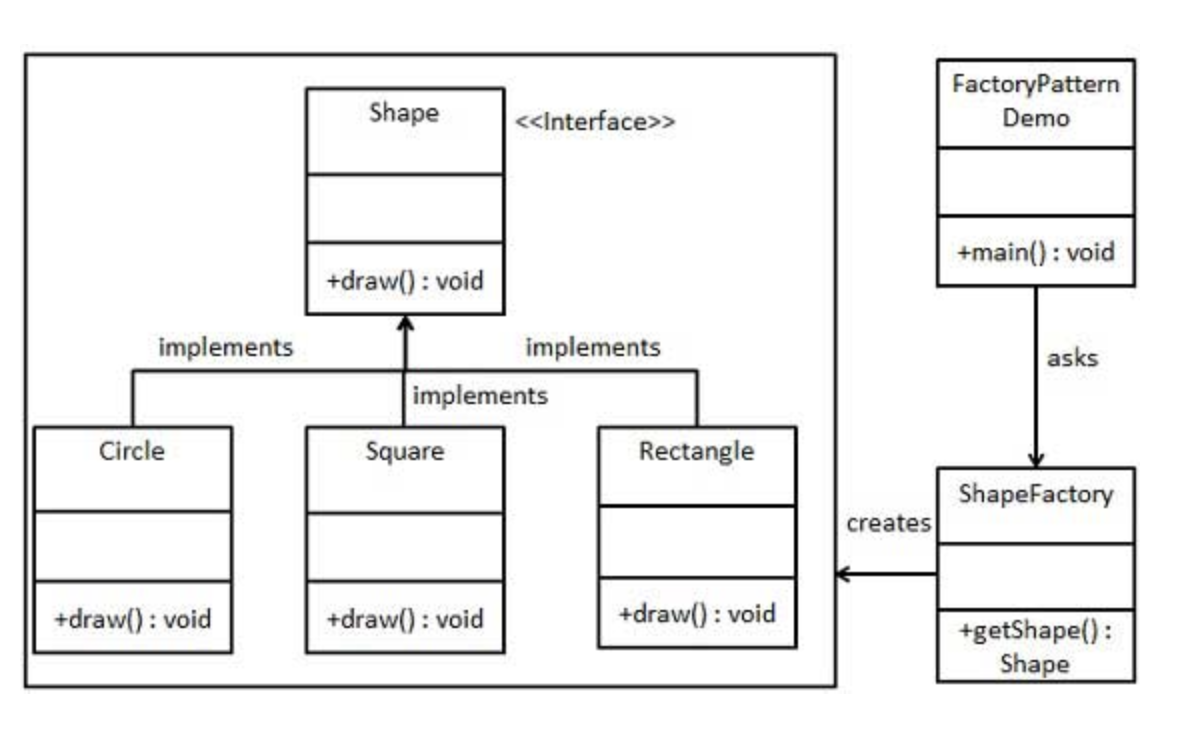
步骤 1
创建一个接口。
Shape.java
java
public interface Shape {
    void draw();
}步骤 2
创建实现接口的实体类。
Rectangle.java
java
public class Rectangle implements Shape {
    @Override
    public void draw() {
        System.out.println("Inside Rectangle::draw() method.");
    }
}Square.java
java
public class Square implements Shape {
    @Override
    public void draw() {
        System.out.println("Inside Square::draw() method.");
    }
}Circle.java
java
public class Circle implements Shape {
    @Override
    public void draw() {
        System.out.println("Inside Circle::draw() method.");
    }
}步骤 3
创建一个工厂,生成基于给定信息的实体类的对象。
ShapeFactory.java
java
public class ShapeFactory {

    //使用 getShape 方法获取形状类型的对象
    public Shape getShape(String shapeType) {
        if (shapeType == null) {
            return null;
        }
        shapeType = shapeType.toLowerCase();

        switch (shapeType) {
            case "circle":
                return new Circle();
            case "rectangle":
                return new Rectangle();
            case "square":
                return new Square();
            default:
                return null;
        }

    }

}步骤 4
使用该工厂,通过传递类型信息来获取实体类的对象。
FactoryPatternDemo.java
java
public class FactoryPatternDemo {

    public static void main(String[] args) {
        ShapeFactory shapeFactory = new ShapeFactory();

        //获取 Circle 的对象,并调用它的 draw 方法
        Shape shape1 = shapeFactory.getShape("CIRCLE");
        //调用 Circle 的 draw 方法
        shape1.draw();

        //获取 Rectangle 的对象,并调用它的 draw 方法
        Shape shape2 = shapeFactory.getShape("RECTANGLE");
        //调用 Rectangle 的 draw 方法
        shape2.draw();

        //获取 Square 的对象,并调用它的 draw 方法
        Shape shape3 = shapeFactory.getShape("SQUARE");
        //调用 Square 的 draw 方法
        shape3.draw();
    }

}步骤 5
验证输出。
java
Inside Circle::draw() method.
Inside Rectangle::draw() method.
Inside Square::draw() method.观察者模式
当对象间存在一对多关系时,则使用观察者模式(Observer Pattern)。比如,当一个对象被修改时,则会自动通知它的依赖对象。观察者模式属于行为型模式。
意图:定义对象间的一种一对多的依赖关系,当一个对象的状态发生改变时,所有依赖于它的对象都得到通知并被自动更新。
主要解决:一个对象状态改变给其他对象通知的问题,而且要考虑到易用和低耦合,保证高度的协作。
实现
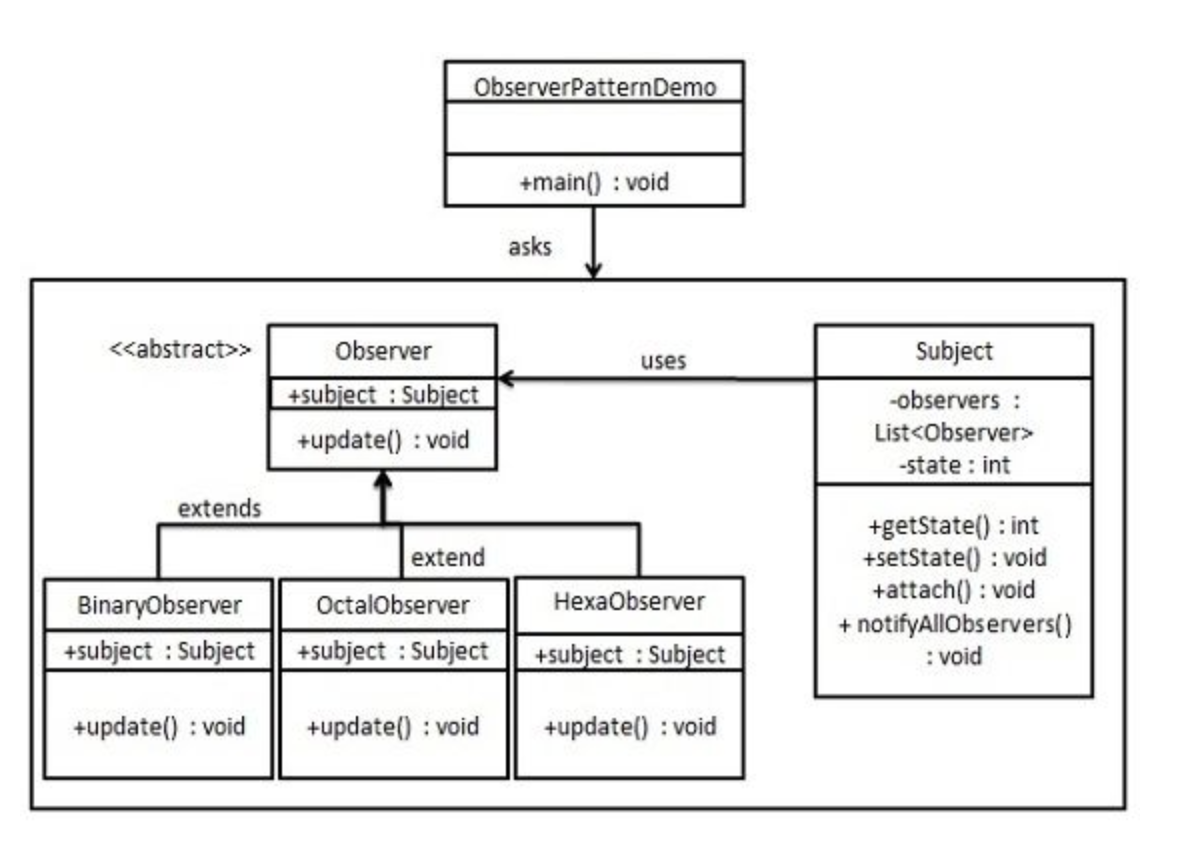
观察者模式使用三个类 Subject、Observer 和 Client。Subject 对象带有绑定观察者到 Client 对象和从 Client 对象解绑观察者的方法。我们创建 Subject 类、Observer 抽象类和扩展了抽象类 Observer 的实体类。
ObserverPatternDemo,我们的演示类使用 Subject 和实体类对象来演示观察者模式。
步骤 1
创建 Subject 类。
Subject.java
java
public class Subject {

    private List<Observer> observers = new ArrayList<>();

    private int state;

    public int getState() {
        return state;
    }

    public void setState(int state) {
        this.state = state;
        notifyAllObservers();
    }

    public void attach(Observer observer) {
        observers.add(observer);
    }

    public void notifyAllObservers() {
        for (Observer observer : observers) {
            observer.update();
        }
    }

}步骤 2
创建 Observer 类。
Observer.java
java
public abstract class Observer {

    protected Subject subject;

    public abstract void update();

}步骤 3
创建实体观察者类。
BinaryObserver.java
java
public class BinaryObserver extends Observer {

    public BinaryObserver(Subject subject) {
        this.subject = subject;
        this.subject.attach(this);
    }

    @Override
    public void update() {
        System.out.println("Binary String: "
                + Integer.toBinaryString(subject.getState()));
    }

}OctalObserver.java
java
public class OctalObserver extends Observer {

    public OctalObserver(Subject subject){
        this.subject = subject;
        this.subject.attach(this);
    }

    @Override
    public void update() {
        System.out.println( "Octal String: "
                + Integer.toOctalString( subject.getState() ) );
    }

}HexaObserver.java
java
public class HexaObserver extends Observer {

    public HexaObserver(Subject subject){
        this.subject = subject;
        this.subject.attach(this);
    }

    @Override
    public void update() {
        System.out.println( "Hex String: "
                + Integer.toHexString( subject.getState() ).toUpperCase() );
    }

}步骤 4
使用 Subject 和实体观察者对象。
ObserverPatternDemo.java
java
public class ObserverPatternDemo {

    public static void main(String[] args) {
        Subject subject = new Subject();

        new BinaryObserver(subject);
        new HexaObserver(subject);
        new OctalObserver(subject);

        System.out.println("First state change: 15");
        subject.setState(15);
        System.out.println();

        System.out.println("Second state change: 10");
        subject.setState(10);
    }

}步骤 5
验证输出。
java
First state change: 15
Binary String: 1111
Hex String: F
Octal String: 17

Second state change: 10
Binary String: 1010
Hex String: A
Octal String: 12装饰器模式
装饰器模式(Decorator Pattern)允许向一个现有的对象添加新的功能,同时又不改变其结构。这种类型的设计模式属于结构型模式,它是作为现有的类的一个包装。
意图:动态地给一个对象添加一些额外的职责。就增加功能来说,装饰器模式相比生成子类更为灵活。
主要解决:一般的,我们为了扩展一个类经常使用继承方式实现,由于继承为类引入静态特征,并且随着扩展功能的增多,子类会很膨胀。
实现
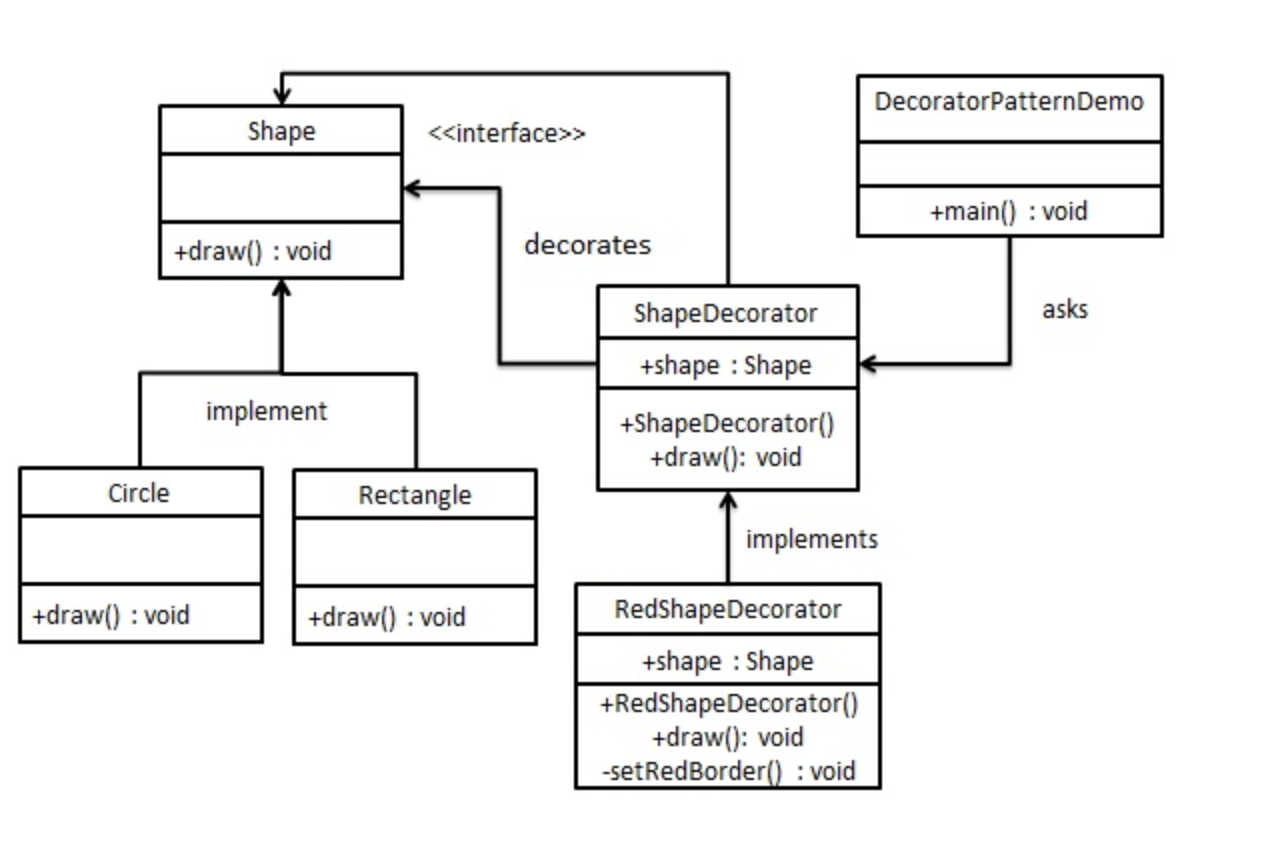
我们将创建一个 Shape 接口和实现了 Shape 接口的实体类。然后我们创建一个实现了 Shape 接口的抽象装饰类 ShapeDecorator,并把 Shape 对象作为它的实例变量。
RedShapeDecorator 是实现了 ShapeDecorator 的实体类。
DecoratorPatternDemo,我们的演示类使用 RedShapeDecorator 来装饰 Shape 对象。
步骤 1
创建一个接口。
Shape.java
java
public interface Shape {

    void draw();

}步骤 2
创建实现接口的实体类。
Rectangle.java
java
public class Rectangle implements Shape {

    @Override
    public void draw() {
        System.out.println("Shape: Rectangle");
    }

}Circle.java
java
public class Circle implements Shape {

    @Override
    public void draw() {
        System.out.println("Shape: Circle");
    }

}步骤 3
创建实现了 Shape 接口的抽象装饰类。
ShapeDecorator.java
java
public abstract class ShapeDecorator implements Shape {

    protected Shape decoratorShape;

    public ShapeDecorator(Shape decoratorShape) {
        this.decoratorShape = decoratorShape;
    }

    @Override
    public void draw() {
        decoratorShape.draw();
    }
}步骤 4
创建扩展了 ShapeDecorator 类的实体装饰类。
RedShapeDecorator.java
java
public class RedShapeDecorator extends ShapeDecorator {

    public RedShapeDecorator(Shape decoratorShape) {
        super(decoratorShape);
    }

    @Override
    public void draw() {
        decoratorShape.draw();
        setRedBorder(decoratorShape);
    }

    private void setRedBorder(Shape decoratorShape) {
        System.out.println("Border Color: Red");
    }

}步骤 5
使用 RedShapeDecorator 来装饰 Shape 对象。
DecoratorPatternDemo.java
java
public class DecoratorPatternDemo {

    public static void main(String[] args) {
        Shape circle = new Circle();
        Shape redCircle = new RedShapeDecorator(new Circle());
        Shape redRectangle = new RedShapeDecorator(new Rectangle());

        System.out.println("Circle with normal border");
        circle.draw();

        System.out.println("\nCircle of red border");
        redCircle.draw();

        System.out.println("\nRectangle of red border");
        redRectangle.draw();

    }

}步骤 6
验证输出。
java
Circle with normal border
Shape: Circle

Circle of red border
Shape: Circle
Border Color: Red

Rectangle of red border
Shape: Rectangle
Border Color: Red秒杀系统设计
什么是秒杀
通俗一点讲就是网络商家为促销等目的组织的网上限时抢购活动
业务特点
- 高并发:秒杀的特点就是这样时间极短、 瞬间用户量大。
- 库存量少:一般秒杀活动商品量很少,这就导致了只有极少量用户能成功购买到。
- 业务简单:流程比较简单,一般都是下订单、扣库存、支付订单
- 恶意请求,数据库压力大
解决方案
前端:页面资源静态化,按钮控制,使用答题校验码可以防止秒杀器的干扰,让更多用户有机会抢到
nginx:校验恶意请求,转发请求,负载均衡;动静分离,不走 tomcat 获取静态资源;gzip 压缩,减少静态文件传输的体积,节省带宽,提高渲染速度
业务层:集群,多台机器处理,提高并发能力
redis:集群保证高可用,持久化数据;分布式锁(悲观锁);缓存热点数据(库存)
mq:削峰限流,MQ 堆积订单,保护订单处理层的负载,Consumer 根据自己的消费能力来取 Task,实际上下游的压力就可控了。重点做好路由层和 MQ 的安全
数据库:读写分离,拆分事务提高并发度
秒杀系统设计小结
- 秒杀系统就是一个“三高”系统,即高并发、高性能和高可用的分布式系统
- 秒杀设计原则:前台请求尽量少,后台数据尽量少,调用链路尽量短,尽量不要有单点
- 秒杀高并发方法:访问拦截、分流、动静分离
- 秒杀数据方法:减库存策略、热点、异步、限流降级
- 访问拦截主要思路:通过 CDN 和缓存技术,尽量把访问拦截在离用户更近的层,尽可能地过滤掉无效请求。
- 分流主要思路:通过分布式集群技术,多台机器处理,提高并发能力。
分布式
分布式概述
分布式
分布式(distributed)是为了解决单个物理服务器容量和性能瓶颈问题而采用的优化手段,将一个业务拆分成不同的子业务,分布在不同的机器上执行。服务之间通过远程调用协同工作,对外提供服务。
该领域需要解决的问题极多,在不同的技术层面上,又包括:分布式缓存、分布式数据库、分布式计算、分布式文件系统等,一些技术如 MQ、Redis、zookeeper 等都跟分布式有关。
从理念上讲,分布式的实现有两种形式:
水平扩展:当一台机器扛不住流量时,就通过添加机器的方式,将流量平分到所有服务器上,所有机器都可以提供 相同的服务;
垂直拆分:前端有多种查询需求时,一台机器扛不住,可以将不同的业务需求分发到不同的机器上,比如 A 机器处理余票查询的请求,B 机器处理支付的请求。
集群
集群(cluster)是指在多台不同的服务器中部署相同应用或服务模块,构成一个集群,通过负载均衡设备对外提供服务。
两个特点
可扩展性:集群中的服务节点,可以动态的添加机器,从而增加集群的处理能力。
高可用性:如果集群某个节点发生故障,这台节点上面运行的服务,可以被其他服务节点接管,从而增强集群的高可用性。
两大能力
负载均衡:负载均衡能把任务比较均衡地分布到集群环境下的计算和网络资源。
集群容错:当我们的系统中用到集群环境,因为各种原因在集群调用失败时,集群容错起到关键性的作用。
微服务
微服务就是很小的服务,小到一个服务只对应一个单一的功能,只做一件事。这个服务可以单独部署运行,服务之间通过远程调用协同工作,每个微服务都是由独立的小团队开发,测试,部署,上线,负责它的整个生命周期。
多线程
多线程(multi-thread):多线程是指程序中包含多个执行流,即在一个程序中可以同时运行多个不同的线程来执行不同的任务。多线程是为了提高 CPU 的利用率。
高并发
高并发(High Concurrency)是一种系统运行过程中发生了一种“短时间内遇到大量请求”的情况,高并发对应的是访问请求,多线程是解决高并发的方法之一,高并发还可以通过分布式,集群,算法优化,数据库优化等方法解决。
分布式系统设计理念
分布式系统的目标与要素
分布式系统的目标是提升系统的整体性能和吞吐量另外还要尽量保证分布式系统的容错性(假如增加 10 台服务器才达到单机运行效果 2 倍左右的性能,那么这个分布式系统就根本没有存在的意义)。
即使采用了分布式系统,我们也要尽力运用并发编程、高性能网络框架等等手段提升单机上的程序性能。
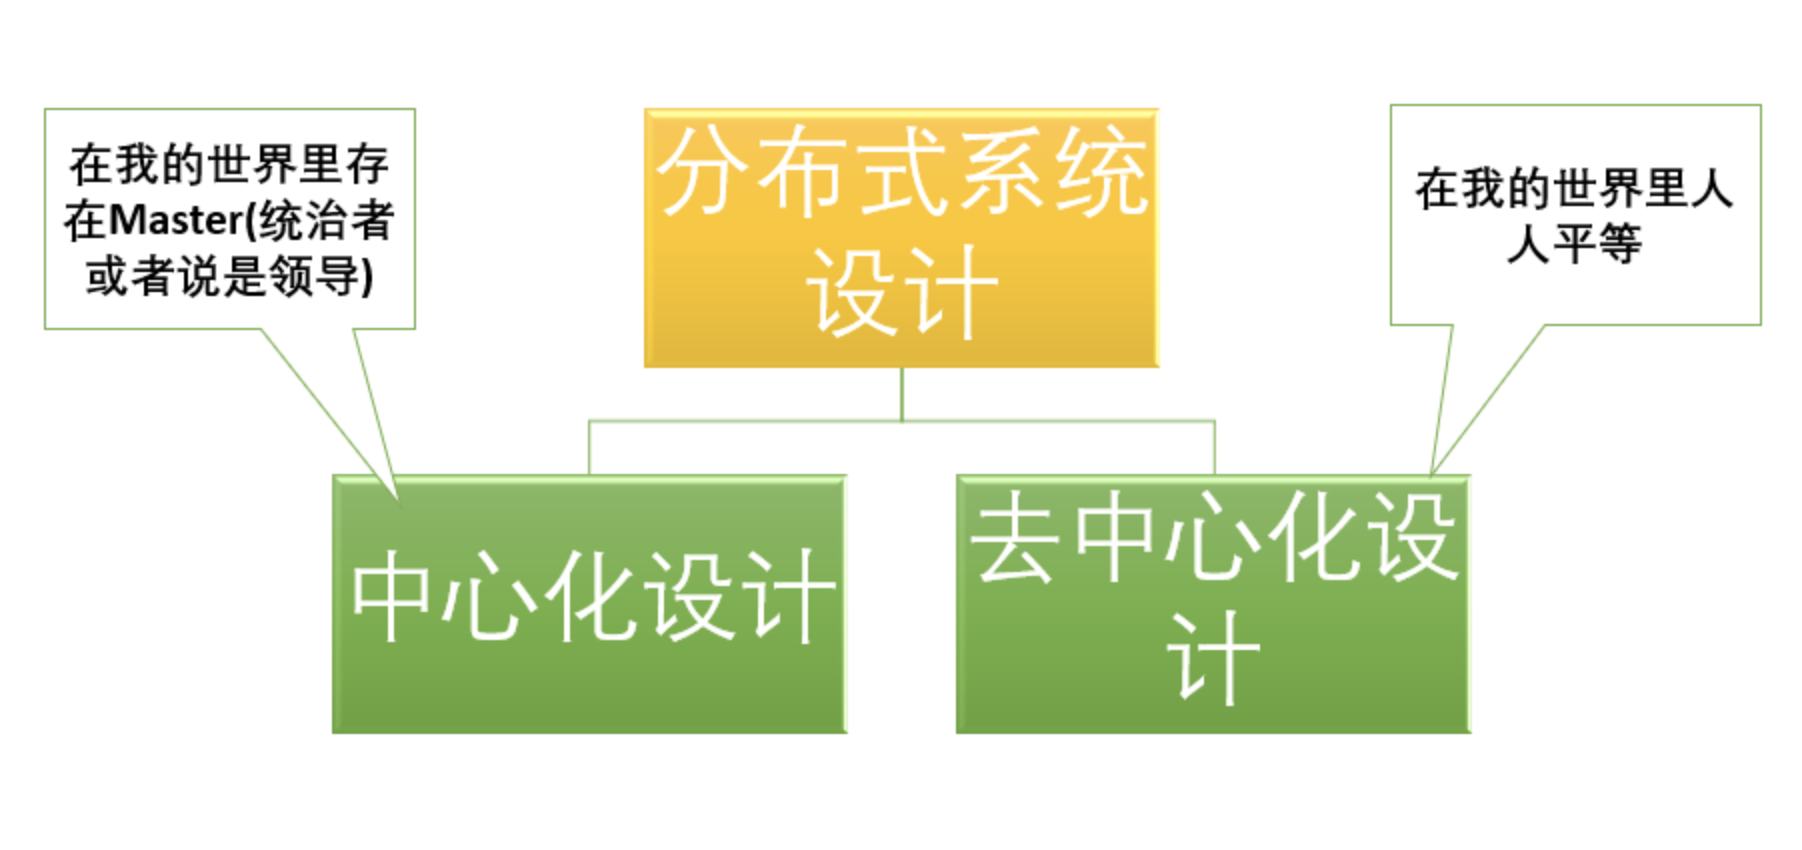
分布式系统设计两大思路:中心化和去中心化
中心化设计
- 两个角色: 中心化的设计思想很简单,分布式集群中的节点机器按照角色分工,大体上分为两种角色: “领导” 和 “干活的”
- 角色职责: “领导”通常负责分发任务并监督“干活的”,发现谁太闲了,就想发设法地给其安排新任务,确保没有一个“干活的”能够偷懒,如果“领导”发现某个“干活的”因为劳累过度而病倒了,则是不会考虑先尝试“医治”他的,而是一脚踢出去,然后把他的任务分给其他人。其中微服务架构 Kubernetes 就恰好采用了这一设计思路。
- 中心化设计的问题
- 中心化的设计存在的最大问题是“领导”的安危问题,如果“领导”出了问题,则群龙无首,整个集群就奔溃了。但我们难以同时安排两个“领导”以避免单点问题。
- 中心化设计还存在另外一个潜在的问题,既“领导”的能力问题:可以领导 10 个人高效工作并不意味着可以领导 100 个人高效工作,所以如果系统设计和实现得不好,问题就会卡在“领导”身上。
- 领导安危问题的解决办法: 大多数中心化系统都采用了主备两个“领导”的设计方案,可以是热备或者冷备,也可以是自动切换或者手动切换,而且越来越多的新系统都开始具备自动选举切换“领导”的能力,以提升系统的可用性。
去中心化设计
- 众生地位平等: 在去中心化的设计里,通常没有“领导”和“干活的”这两种角色的区分,大家的角色都是一样的,地位是平等的,全球互联网就是一个典型的去中心化的分布式系统,联网的任意节点设备宕机,都只会影响很小范围的功能。
- “去中心化”不是不要中心,而是由节点来自由选择中心。 (集群的成员会自发的举行“会议”选举新的“领导”主持工作。最典型的案例就是 ZooKeeper 及 Go 语言实现的 Etcd)
- 去中心化设计的问题: 去中心化设计里最难解决的一个问题是 “脑裂”问题 ,这种情况的发生概率很低,但影响很大。脑裂指一个集群由于网络的故障,被分为至少两个彼此无法通信的单独集群,此时如果两个集群都各自工作,则可能会产生严重的数据冲突和错误。一般的设计思路是,当集群判断发生了脑裂问题时,规模较小的集群就“自杀”或者拒绝服务。
分布式与集群的区别是什么?
- 分布式: 一个业务分拆多个子业务,部署在不同的服务器上
- 集群: 同一个业务,部署在多个服务器上。比如之前做电商网站搭的 redis 集群以及 solr 集群都是属于将 redis 服务器提供的缓存服务以及 solr 服务器提供的搜索服务部署在多个服务器上以提高系统性能、并发量解决海量存储问题。
CAP 定理
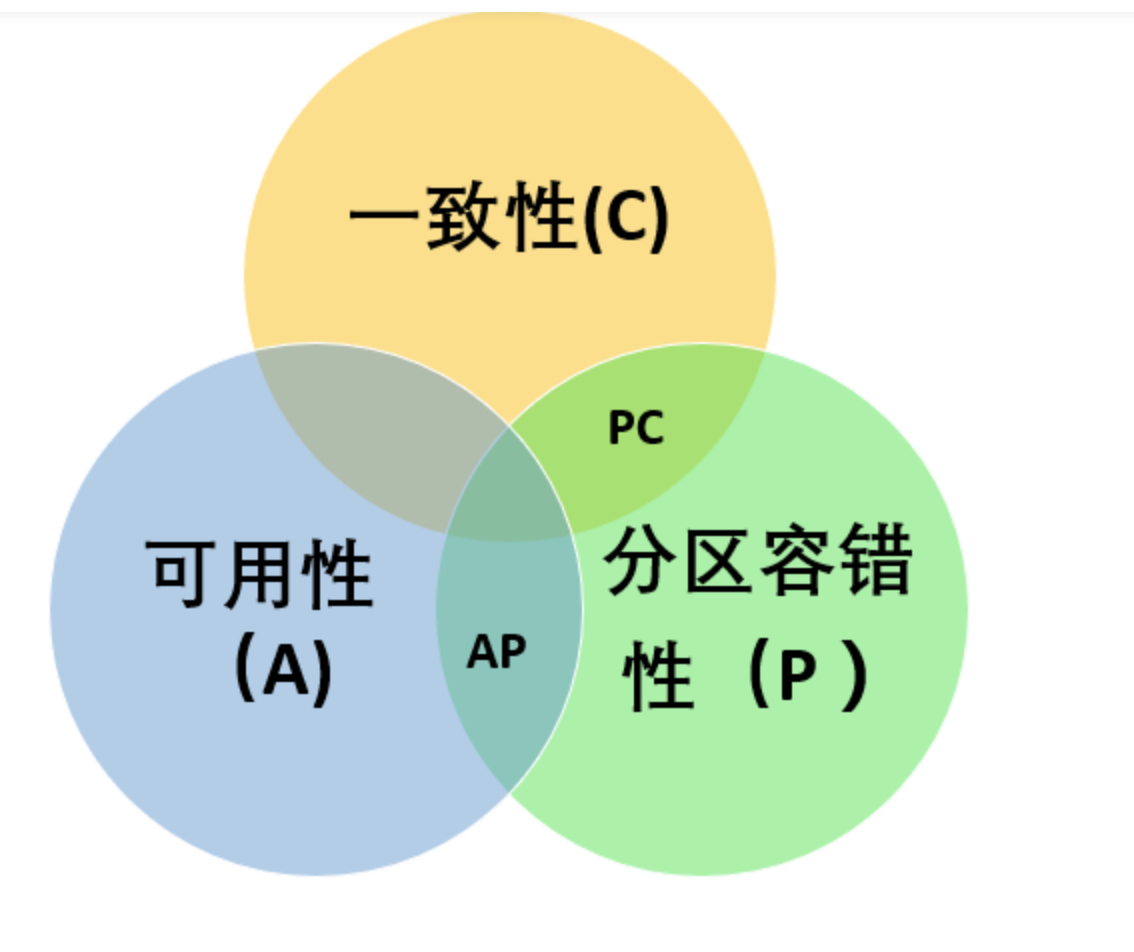
在理论计算机科学中,CAP 定理(CAP theorem),又被称作布鲁尔定理(Brewer’s theorem),它指出对于一个分布式计算系统来说,不可能同时满足以下三点:
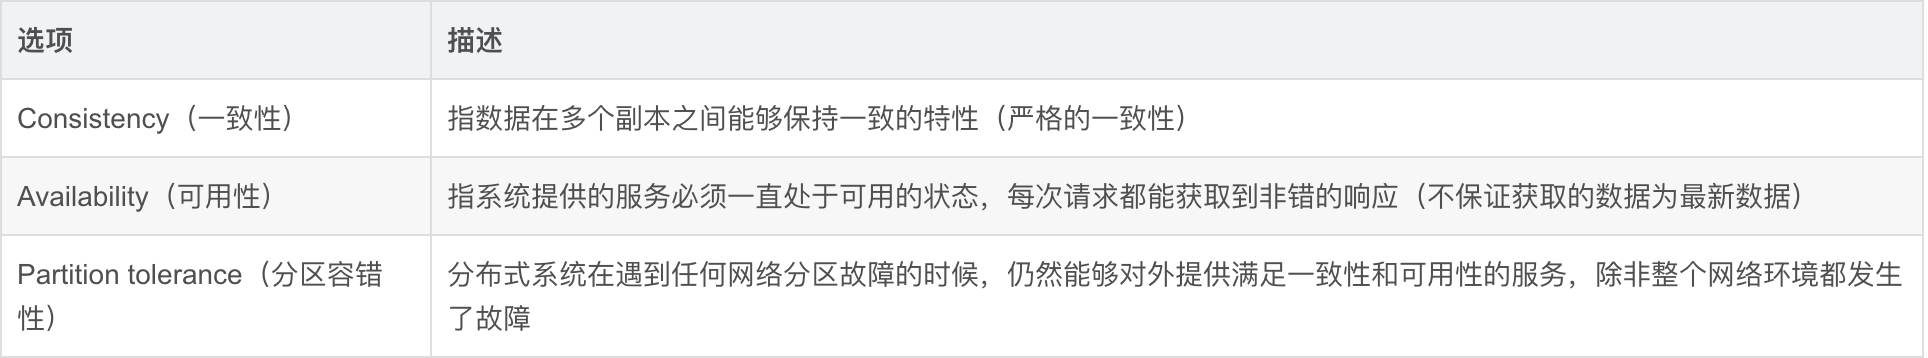
Spring Cloud 在 CAP 法则上主要满足的是 A 和 P 法则,Dubbo 和 Zookeeper 在 CAP 法则主要满足的是 C 和 P 法则
CAP 仅适用于原子读写的 NOSQL 场景中,并不适合数据库系统。现在的分布式系统具有更多特性比如扩展性、可用性等等,在进行系统设计和开发时,我们不应该仅仅局限在 CAP 问题上。
注意:不是所谓的 3 选 2(不要被网上大多数文章误导了)
现实生活中,大部分人解释这一定律时,常常简单的表述为:“一致性、可用性、分区容忍性三者你只能同时达到其中两个,不可能同时达到”。实际上这是一个非常具有误导性质的说法,而且在 CAP 理论诞生 12 年之后,CAP 之父也在 2012 年重写了之前的论文。
当发生网络分区的时候,如果我们要继续服务,那么强一致性和可用性只能 2 选 1。也就是说当网络分区之后 P 是前提,决定了 P 之后才有 C 和 A 的选择。也就是说分区容错性(Partition tolerance)我们是必须要实现的。
CAP 定理的证明
关于 CAP 这三个特性我们就介绍完了,接下来我们试着证明一下为什么 CAP 不能同时满足。
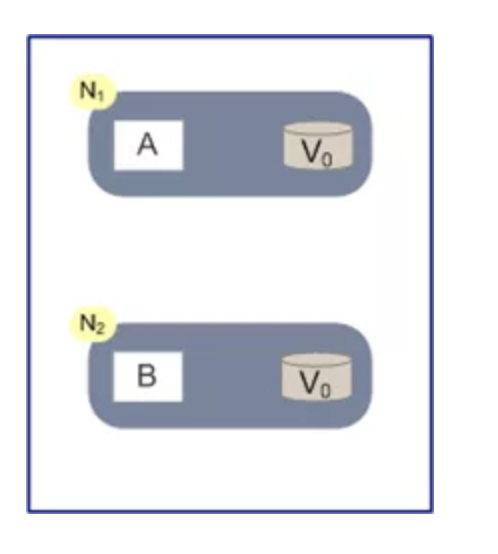
为了简化证明的过程,我们假设整个集群里只有两个 N1 和 N2 两个节点,如下图:
N1 和 N2 当中各自有一个应用程序 AB 和数据库,当系统满足一致性的时候,我们认为 N1 和 N2 数据库中的数据保持一致。在满足可用性的时候,我们认为无论用户访问 N1 还是 N2,都可以获得正确的结果,在满足分区容错性的时候,我们认为无论 N1 还是 N2 宕机或者是两者的通信中断,都不影响系统的运行。
我们假设一种极端情况,假设某个时刻 N1 和 N2 之间的网络通信突然中断了。如果系统满足分区容错性,那么显然可以支持这种异常。问题是在此前提下,一致性和可用性是否可以做到不受影响呢?
我们做个假象实验,如下图,突然某一时刻 N1 和 N2 之间的关联断开:
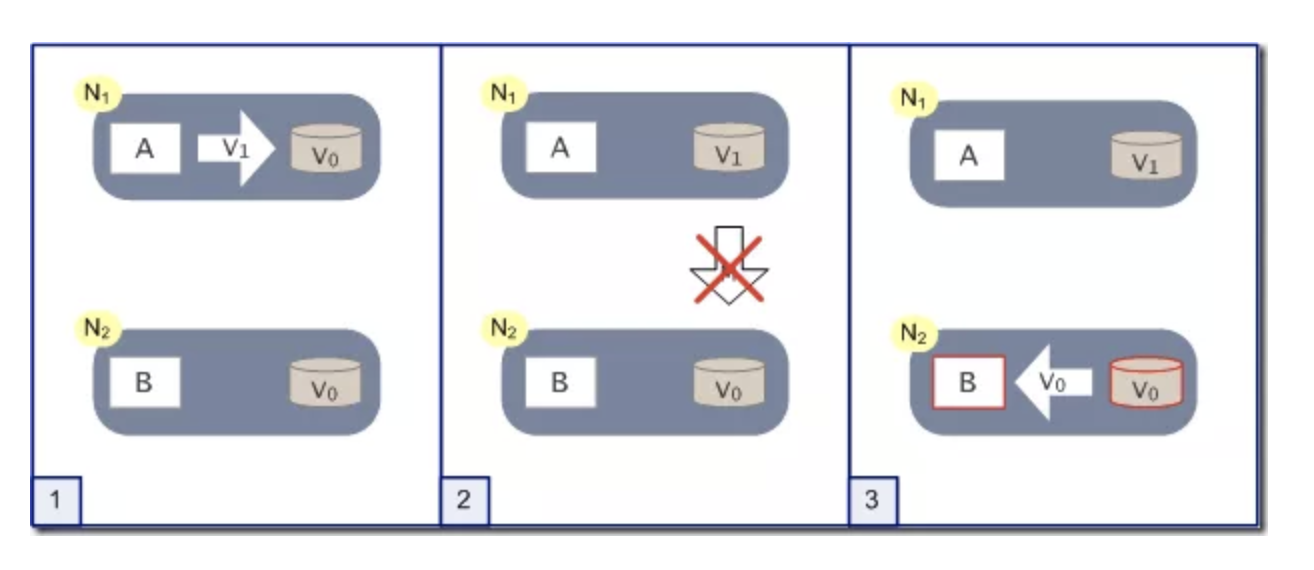
有用户向 N1 发送了请求更改了数据,将数据库从 V0 更新成了 V1。由于网络断开,所以 N2 数据库依然是 V0,如果这个时候有一个请求发给了 N2,但是 N2 并没有办法可以直接给出最新的结果 V1,这个时候该怎么办呢?
这个时候无法两种方法,一种是将错就错,将错误的 V0 数据返回给用户。第二种是阻塞等待,等待网络通信恢复,N2 中的数据更新之后再返回给用户。显然前者牺牲了一致性,后者牺牲了可用性。
这个例子虽然简单,但是说明的内容却很重要。在分布式系统当中,CAP 三个特性我们是无法同时满足的,必然要舍弃一个。三者舍弃一个,显然排列组合一共有三种可能。
BASE 理论
BASE 理论由 eBay 架构师 Dan Pritchett 提出,在 2008 年上被分表为论文,并且 eBay 给出了他们在实践中总结的基于 BASE 理论的一套新的分布式事务解决方案。
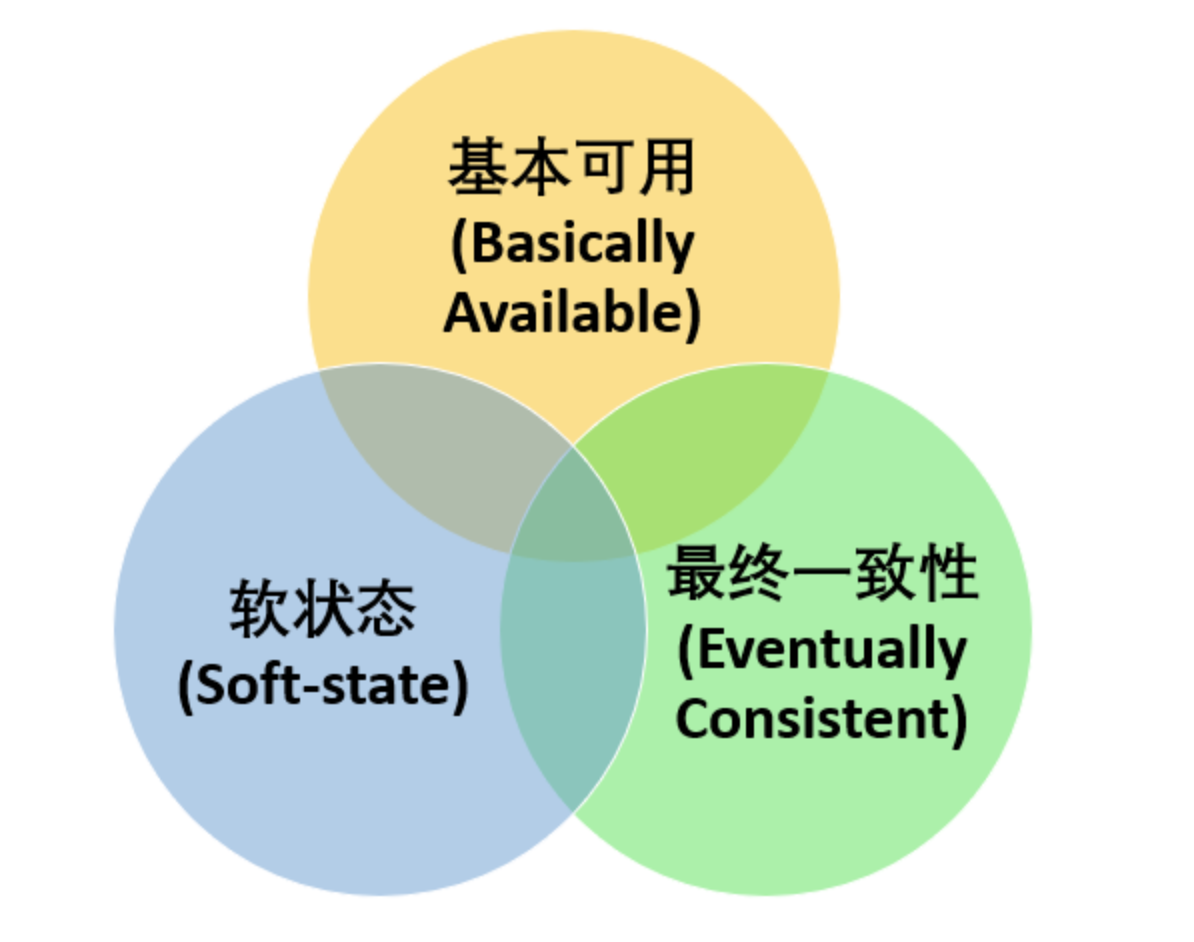
BASE 是 Basically Available(基本可用) 、Soft-state(软状态) 和 Eventually Consistent(最终一致性) 三个短语的缩写。BASE 理论是对 CAP 中一致性和可用性权衡的结果,其来源于对大规模互联网系统分布式实践的总结,是基于 CAP 定理逐步演化而来的,它大大降低了我们对系统的要求。
BASE 理论的核心思想
即使无法做到强一致性,但每个应用都可以根据自身业务特点,采用适当的方式来使系统达到最终一致性。也就是牺牲数据的一致性来满足系统的高可用性,系统中一部分数据不可用或者不一致时,仍需要保持系统整体“主要可用”。
针对数据库领域,BASE 思想的主要实现是对业务数据进行拆分,让不同的数据分布在不同的机器上,以提升系统的可用性,当前主要有以下两种做法:
- 按功能划分数据库
- 分片(如开源的 Mycat、Amoeba 等)。
由于拆分后会涉及分布式事务问题,所以 eBay 在该 BASE 论文中提到了如何用最终一致性的思路来实现高性能的分布式事务。
BASE 理论三要素
1. 基本可用
基本可用是指分布式系统在出现不可预知故障的时候,允许损失部分可用性。但是,这绝不等价于系统不可用。
比如:
- 响应时间上的损失:正常情况下,一个在线搜索引擎需要在 0.5 秒之内返回给用户相应的查询结果,但由于出现故障,查询结果的响应时间增加了 1~2 秒
- 系统功能上的损失:正常情况下,在一个电子商务网站上进行购物的时候,消费者几乎能够顺利完成每一笔订单,但是在一些节日大促购物高峰的时候,由于消费者的购物行为激增,为了保护购物系统的稳定性,部分消费者可能会被引导到一个降级页面
2. 软状态
软状态指允许系统中的数据存在中间状态,并认为该中间状态的存在不会影响系统的整体可用性,即允许系统在不同节点的数据副本之间进行数据同步的过程存在延时
3. 最终一致性
最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能够达到一个一致的状态。因此,最终一致性的本质是需要系统保证最终数据能够达到一致,而不需要实时保证系统数据的强一致性。
数据结构与算法
冒泡排序
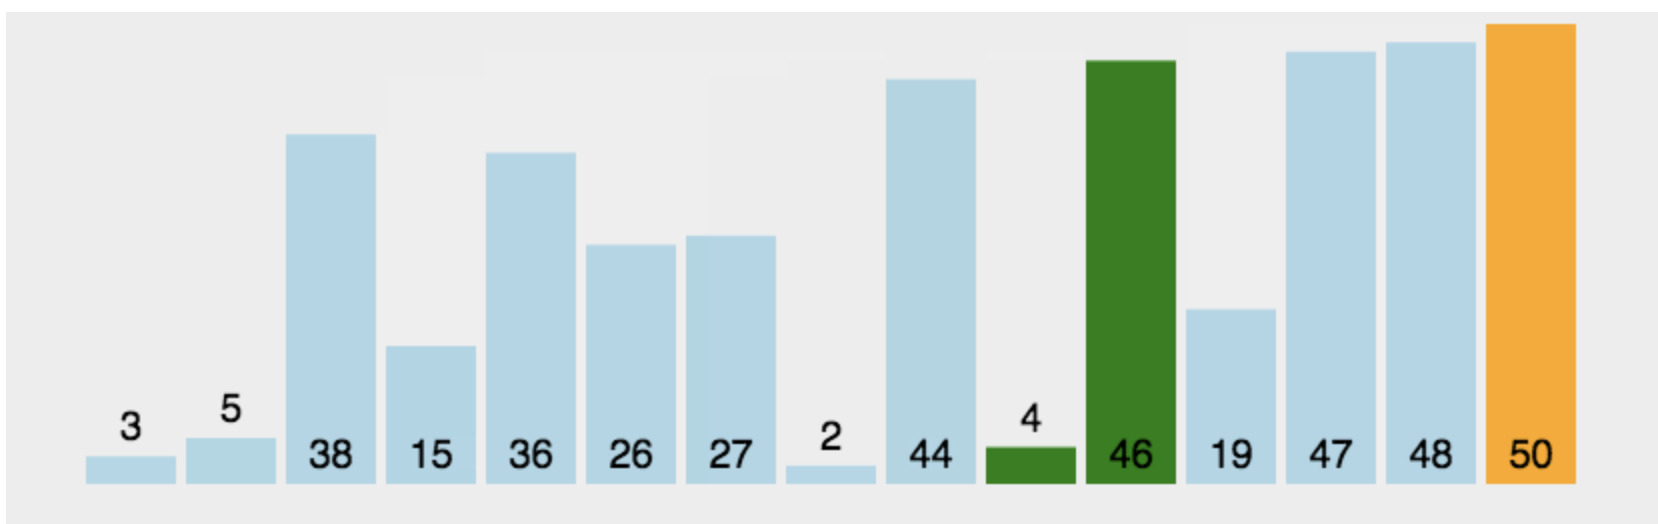
冒泡排序是一种简单的排序算法。它重复地走访过要排序的数列,依次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。
算法描述
- 比较相邻的元素。如果第一个比第二个大,就交换它们两个;
- 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这样在最后的元素应该会是最大的数;
- 针对所有的元素重复以上的步骤,除了最后一个;
- 重复步骤 1~3,直到排序完成。
动图演示
代码实现
下面的排序算法统一使用的测试代码如下,源码GitHub链接
java
public static void main(String[] args) {
    int[] array = {3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48};
	// 只需要修改成对应的方法名就可以了
    bubbleSort(array);

    System.out.println(Arrays.toString(array));
}java
/**
 * Description:冒泡排序
 *
 * @param array 需要排序的数组
 * @author JourWon
 * @date 2019/7/11 9:54
 */
public static void bubbleSort(int[] array) {
	if (array == null || array.length <= 1) {
		return;
	}

	int length = array.length;

	// 外层循环控制比较轮数i
	for (int i = 0; i < length; i++) {
		// 内层循环控制每一轮比较次数,每进行一轮排序都会找出一个较大值
		// (array.length - 1)防止索引越界,(array.length - 1 - i)减少比较次数
		for (int j = 0; j < length - 1 - i; j++) {
			// 前面的数大于后面的数就进行交换
			if (array[j] > array[j + 1]) {
				int temp = array[j + 1];
				array[j + 1] = array[j];
				array[j] = temp;
			}
		}
	}

}算法分析
最佳情况:T(n) = O(n) 最差情况:T(n) = O(n2) 平均情况:T(n) = O(n2)
选择排序
表现最稳定的排序算法之一,因为无论什么数据进去都是 O(n2) 的时间复杂度,所以用到它的时候,数据规模越小越好。唯一的好处可能就是不占用额外的内存空间了吧。理论上讲,选择排序可能也是平时排序一般人想到的最多的排序方法了吧。
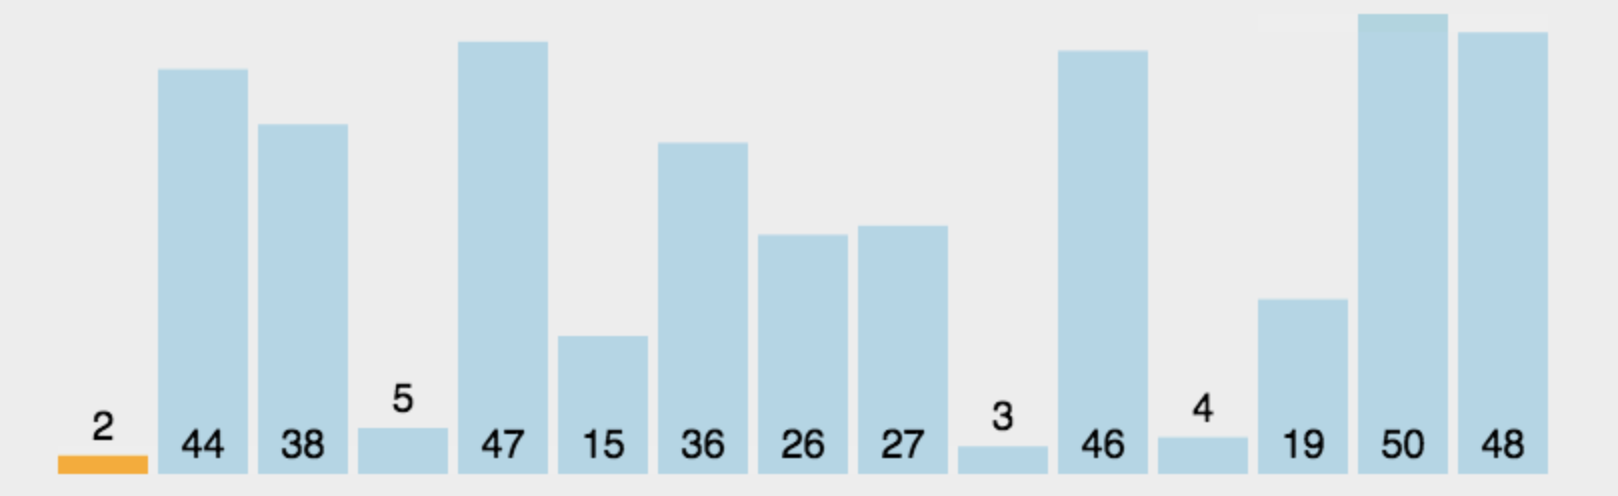
选择排序 (Selection-sort) 是一种简单直观的排序算法。它的工作原理:首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置,然后,再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
算法描述
n 个记录的直接选择排序可经过 n-1 趟直接选择排序得到有序结果。具体算法描述如下:
- 初始状态:无序区为 R[1…n],有序区为空;
- 第 i 趟排序 (i=1,2,3…n-1) 开始时,当前有序区和无序区分别为 R[1…i-1] 和 R(i…n)。该趟排序从当前无序区中-选出关键字最小的记录 R[k],将它与无序区的第 1 个记录 R 交换,使 R[1…i] 和 R[i+1…n) 分别变为记录个数增加 1 个的新有序区和记录个数减少 1 个的新无序区;
- n-1 趟结束,数组有序化了。
动图演示
代码实现
下面的排序算法统一使用的测试代码如下,源码GitHub链接
java
public static void main(String[] args) {
    int[] array = {3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48};
	// 只需要修改成对应的方法名就可以了
    selectionSort(array);

    System.out.println(Arrays.toString(array));
}java
/**
 * Description: 选择排序
 *
 * @param array
 * @return void
 * @author JourWon
 * @date 2019/7/11 23:31
 */
public static void selectionSort(int[] array) {
	if (array == null || array.length <= 1) {
		return;
	}

	int length = array.length;

	for (int i = 0; i < length - 1; i++) {
		// 保存最小数的索引
		int minIndex = i;

		for (int j = i + 1; j < length; j++) {
			// 找到最小的数
			if (array[j] < array[minIndex]) {
				minIndex = j;
			}
		}

		// 交换元素位置
		if (i != minIndex) {
			swap(array, minIndex, i);
		}
	}

}

/**
 * Description: 交换元素位置
 *
 * @param array
 * @param a
 * @param b
 * @return void
 * @author JourWon
 * @date 2019/7/11 17:57
 */
private static void swap(int[] array, int a, int b) {
	int temp = array[a];
	array[a] = array[b];
	array[b] = temp;
}算法分析
最佳情况:T(n) = O(n2) 最差情况:T(n) = O(n2) 平均情况:T(n) = O(n2)
快速排序
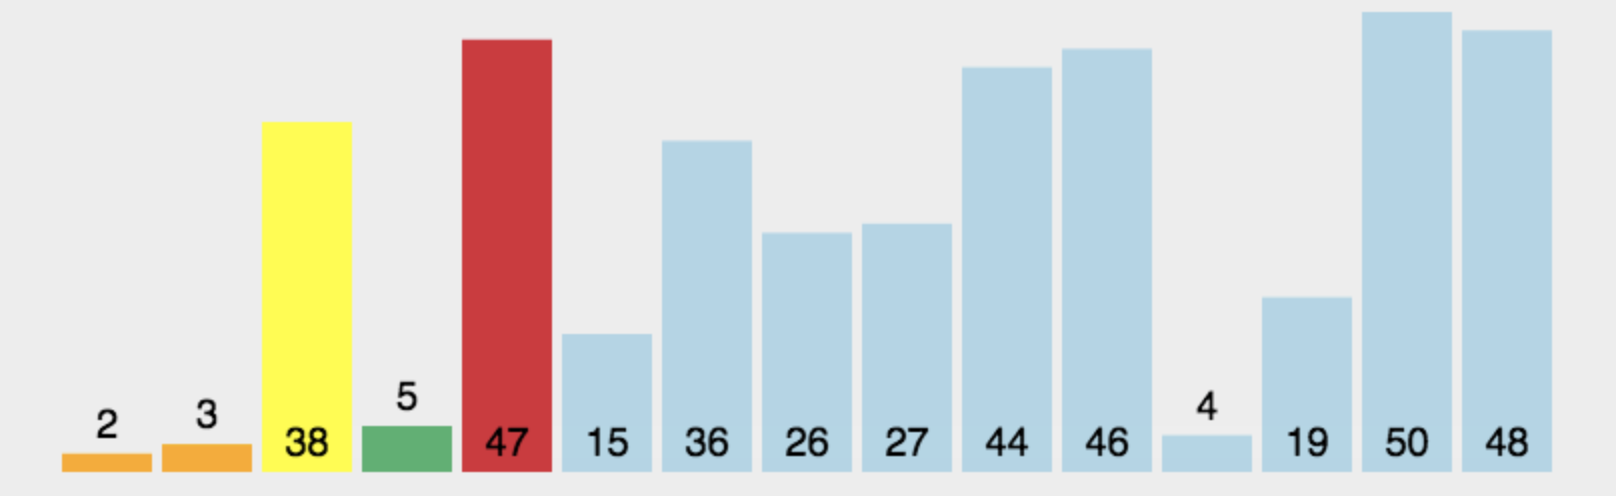
快速排序的基本思想:通过一趟排序将待排记录分隔成独立的两部分,其中一部分记录的关键字均比另一部分的关键字小,则可分别对这两部分记录继续进行排序,以达到整个序列有序。
算法描述
快速排序使用分治法来把一个串(list)分为两个子串(sub-lists)。具体算法描述如下:
- 从数列中挑出一个元素,称为 “基准”(pivot);
- 重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区退出之后,该基准就处于数列的中间位置。这个称为分区(partition)操作;
- 递归地(recursive)把小于基准值元素的子数列和大于基准值元素的子数列排序。
动图演示
代码实现
下面的排序算法统一使用的测试代码如下,源码GitHub链接
java
public static void main(String[] args) {
    int[] array = {3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48};
	// 只需要修改成对应的方法名就可以了
    quickSort(array);

    System.out.println(Arrays.toString(array));
}java
public static void quickSort(int[] array) {
	quickSort(array, 0, array.length - 1);
}

private static void quickSort(int[] array, int left, int right) {
	if (array == null || left >= right || array.length <= 1) {
		return;
	}
	int mid = partition(array, left, right);
	quickSort(array, left, mid);
	quickSort(array, mid + 1, right);
}

private static int partition(int[] array, int left, int right) {
	int temp = array[left];
	while (right > left) {
		// 先判断基准数和后面的数依次比较
		while (temp <= array[right] && left < right) {
			--right;
		}
		// 当基准数大于了 arr[left],则填坑
		if (left < right) {
			array[left] = array[right];
			++left;
		}
		// 现在是 arr[right] 需要填坑了
		while (temp >= array[left] && left < right) {
			++left;
		}
		if (left < right) {
			array[right] = array[left];
			--right;
		}
	}
	array[left] = temp;
	return left;
}算法分析
最佳情况:T(n) = O(nlogn) 最差情况:T(n) = O(n2) 平均情况:T(n) = O(nlogn)
递归
什么叫递归
递归函数就是直接或间接调用自身的函数,也就是自身调用自己。
一般什么时候使用递归?
递归是常用的编程技术,其基本思想就是“自己调用自己”,一个使用递归技术的方法即是直接或间接的调用自身的方法。递归方法实际上体现了“以此类推”、“用同样的步骤重复”这样的思想。
还有些数据结构如二叉树,结构本身固有递归特性;此外,有一类问题,其本身没有明显的递归结构,但用递归程序求解比其他方法更容易编写程序。
需满足的两个条件
- 有反复执行的过程 (调用自身)
- 有跳出反复执行过程的条件 (递归出口)
经典问题:阶乘
java
递归阶乘n! = n * (n-1) * (n-2) * ...* 1(n>0)java
public static Integer recursionMulity(Integer n) {
    if (n == 1) {
        return 1;
    }
    return n * recursionMulity(n - 1);
}经典问题:不死神兔(斐波那契数列)
3 个月起每个月都生一对兔子,小兔子长到第三个月后每个月又生一对兔子,假如兔子都不死,问每个月的兔子总数为多少?
分析:首先我们要明白题目的意思指的是每个月的兔子总对数;假设将兔子分为小中大三种,兔子从出生后三个月后每个月就会生出一对兔子,
那么我们假定第一个月的兔子为小兔子,第二个月为中兔子,第三个月之后就为大兔子,那么第一个月分别有 1、0、0,第二个月分别为 0、1、0,
第三个月分别为 1、0、1,第四个月分别为,1、1、1,第五个月分别为 2、1、2,第六个月分别为 3、2、3,第七个月分别为 5、3、5……
兔子总数分别为:1、1、2、3、5、8、13……
于是得出了一个规律,从第三个月起,后面的兔子总数都等于前面两个月的兔子总数之和,即为斐波那契数列。
java
public static int fib(int mon) {
    if (mon < 2) {
        return 1;
    } else {
        return fib(mon - 1) + fib(mon - 2);
    }
}二分查找
在数组[130,150,170,190,210,230,250,270,290,310] 中查找数字 190,红色为二分线 (折半线),灰色为查找区域,黑色为排除区域。
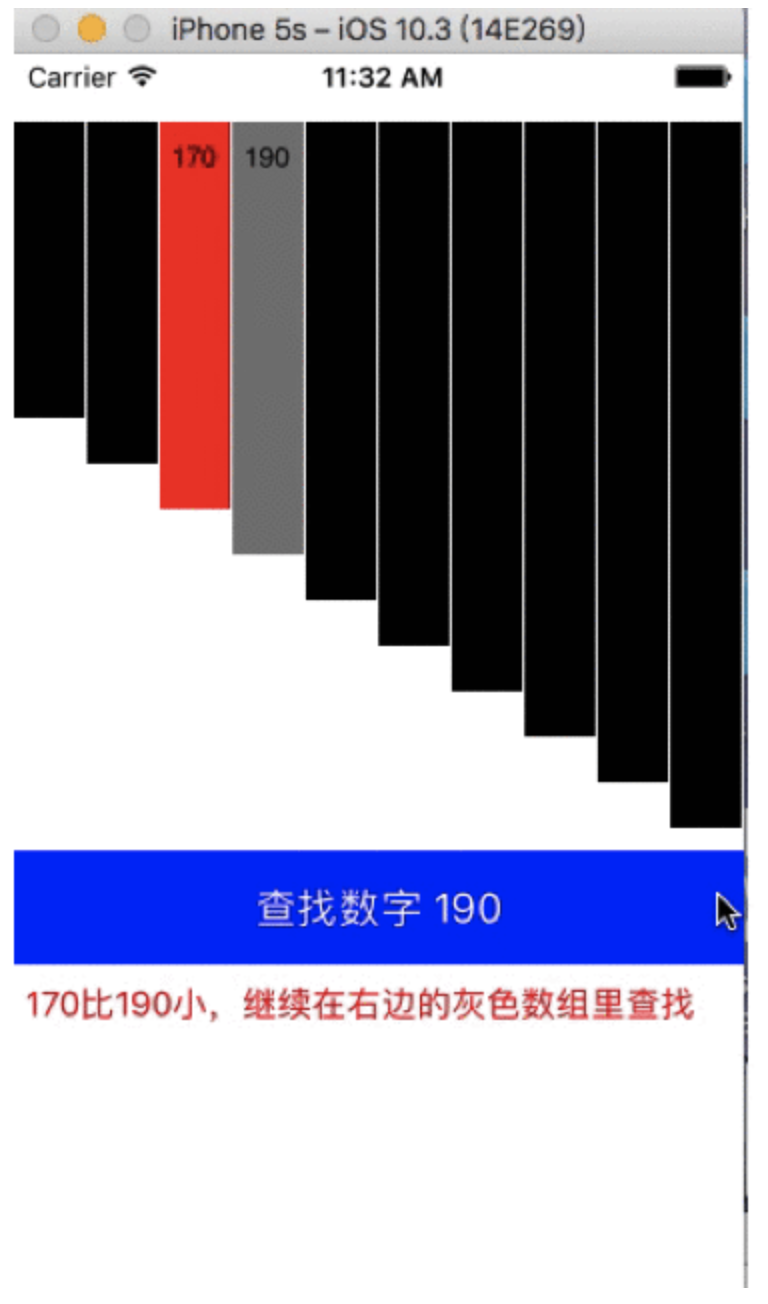
二分查找也称折半查找(Binary Search),它是一种效率较高的查找方法,前提是数据结构必须先排好序,时间复杂度可以表示 O(h)=O(log2n),以 2 为底,n 的对数。其缺点是要求待查表为有序表,且插入删除困难。
左加右不加,找右缩左,找左缩右
java
public class BinarySearch {
    public static void main(String[] args) {
        int[] arr = {5, 12, 23, 43, 66, 98, 100};
        System.out.println(binarySort(arr, 23));
    }

    /**
     * 循环实现二分查找
     *
     * @param arr
     * @param key
     * @return
     */
    public static int binarySearch(int[] arr, int key) {
        //第一个下标
        int low = 0;
        //最后一个下标
        int high = arr.length - 1;
        int mid = 0;
        //防越界
        if (key < arr[low] || key > arr[high] || low > high) {
            return -1;
        }
        while (low <= high) {
            mid = (low + high) >>> 1;
            if (key < arr[mid]) {
                high = mid - 1;
            } else if (key > arr[mid]) {
                low = mid + 1;
            } else {
                return mid;
            }
        }
        return -1;
    }
}二分查找中中间值的计算
这是一个经典的话题,如何计算二分查找中的中值?大家一般给出了两种计算方法:
- 算法一:
mid = (low + high) / 2 - 算法二:
mid = low + (high – low)/2
乍看起来,算法一简洁,算法二提取之后,跟算法一没有什么区别。但是实际上,区别是存在的。算法一的做法,在极端情况下,(low + high) 存在着溢出的风险,进而得到错误的 mid 结果,导致程序错误。而算法二能够保证计算出来的 mid,一定大于 low,小于 high,不存在溢出的问题。
一致性 Hash 算法
概述
一致性 Hash 是一种特殊的 Hash 算法,由于其均衡性、持久性的映射特点,被广泛的应用于负载均衡领域和分布式存储,如 nginx 和 memcached 都采用了一致性 Hash 来作为集群负载均衡的方案。
普通的 Hash 函数最大的作用是散列,或者说是将一系列在形式上具有相似性质的数据,打散成随机的、均匀分布的数据。不难发现,这样的 Hash 只要集群的数量 N 发生变化,之前的所有 Hash 映射就会全部失效。如果集群中的每个机器提供的服务没有差别,倒不会产生什么影响,但对于分布式缓存这样的系统而言,映射全部失效就意味着之前的缓存全部失效,后果将会是灾难性的。一致性 Hash 通过构建环状的 Hash 空间代替线性 Hash 空间的方法解决了这个问题。
良好的分布式 cahce 系统中的一致性 hash 算法应该满足以下几个方面:
- 平衡性 (Balance)
平衡性是指哈希的结果能够尽可能分布到所有的缓冲中去,这样可以使得所有的缓冲空间都得到利用。很多哈希算法都能够满足这一条件。
- 单调性 (Monotonicity)
单调性是指如果已经有一些内容通过哈希分派到了相应的缓冲中,又有新的缓冲区加入到系统中,那么哈希的结果应能够保证原有已分配的内容可以被映射到新的缓冲区中去,而不会被映射到旧的缓冲集合中的其他缓冲区。
- 分散性 (Spread)
在分布式环境中,终端有可能看不到所有的缓冲,而是只能看到其中的一部分。当终端希望通过哈希过程将内容映射到缓冲上时,由于不同终端所见的缓冲范围有可能不同,从而导致哈希的结果不一致,最终的结果是相同的内容被不同的终端映射到不同的缓冲区中。这种情况显然是应该避免的,因为它导致相同内容被存储到不同缓冲中去,降低了系统存储的效率。分散性的定义就是上述情况发生的严重程度。好的哈希算法应能够尽量避免不一致的情况发生,也就是尽量降低分散性。
- 负载 (Load)
负载问题实际上是从另一个角度看待分散性问题。既然不同的终端可能将相同的内容映射到不同的缓冲区中,那么对于一个特定的缓冲区而言,也可能被不同的用户映射为不同的内容。与分散性一样,这种情况也是应当避免的,因此好的哈希算法应能够尽量降低缓冲的负荷。
- 平滑性 (Smoothness)
平滑性是指缓存服务器的数目平滑改变和缓存对象的平滑改变是一致的。
一致性 Hash 算法原理
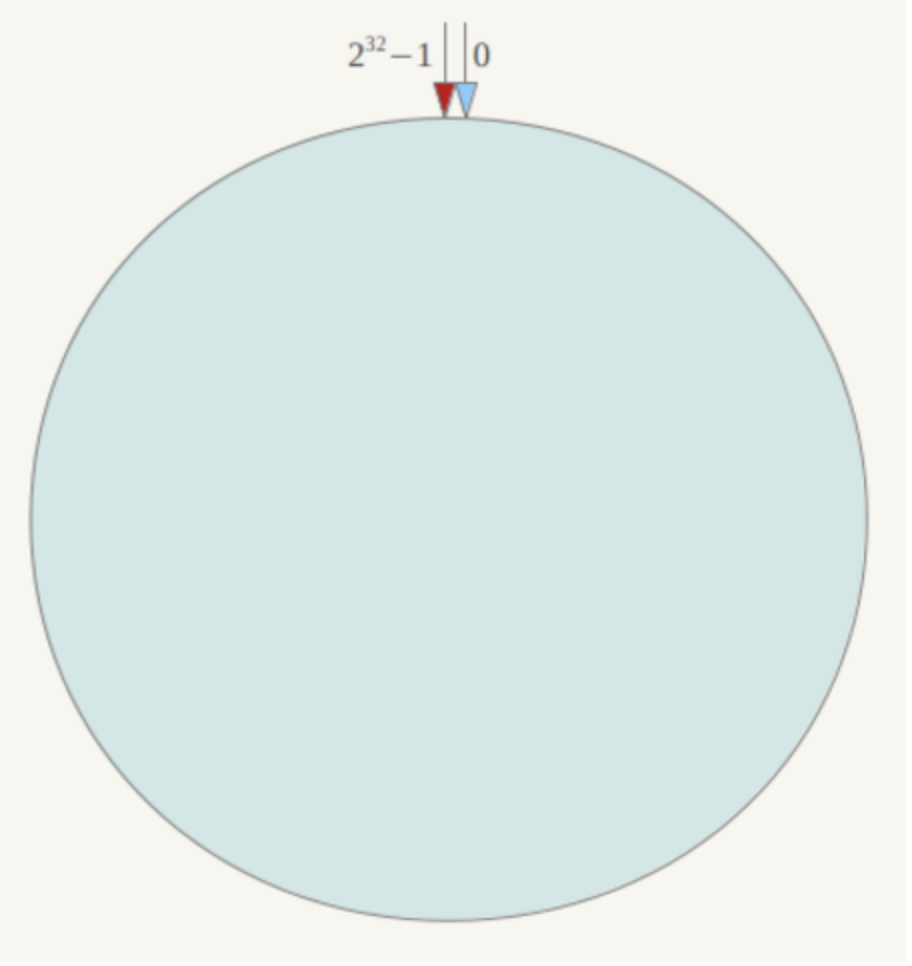
简单来说,一致性哈希将整个哈希值空间组织成一个虚拟的圆环,如假设某哈希函数 H 的值空间为 0-2<sup>32-1(即哈希值是一个 32 位无符号整形),整个哈希空间环如下:整个空间按顺时针方向组织。0 和 2</sup>32-1 在零点中方向重合。
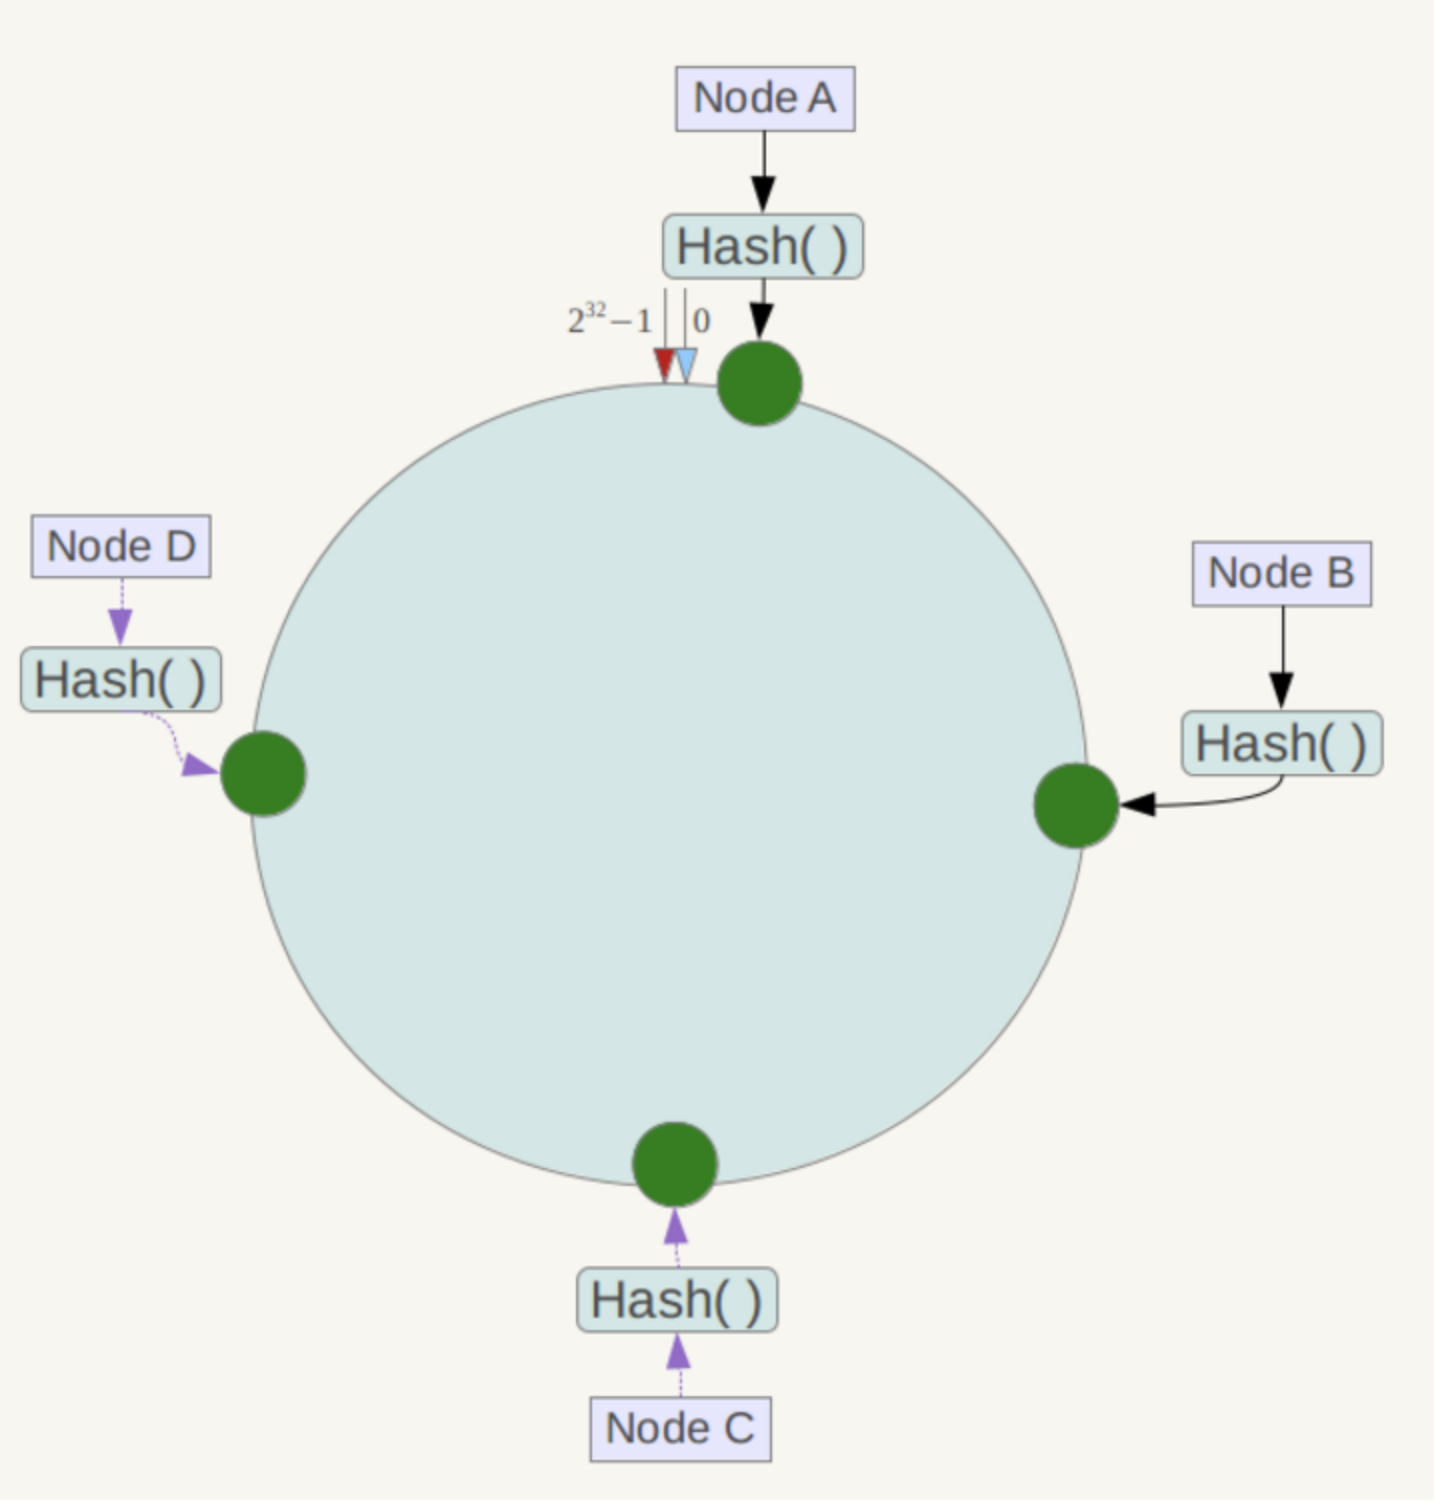
下一步将各个服务器使用 Hash 进行一次哈希,具体可以选择服务器的 ip 或主机名作为关键字进行哈希,这样每台机器就能确定其在哈希环上的位置,这里假设将上文中四台服务器使用 ip 地址哈希后在环空间的位置如下:
接下来使用如下算法定位数据访问到相应服务器:将数据 key 使用相同的函数 Hash 计算出哈希值,并确定此数据在环上的位置,从此位置沿环顺时针“行走”,第一台遇到的服务器就是其应该定位到的服务器。
例如我们有 Object A、Object B、Object C、Object D 四个数据对象,经过哈希计算后,在环空间上的位置如下:
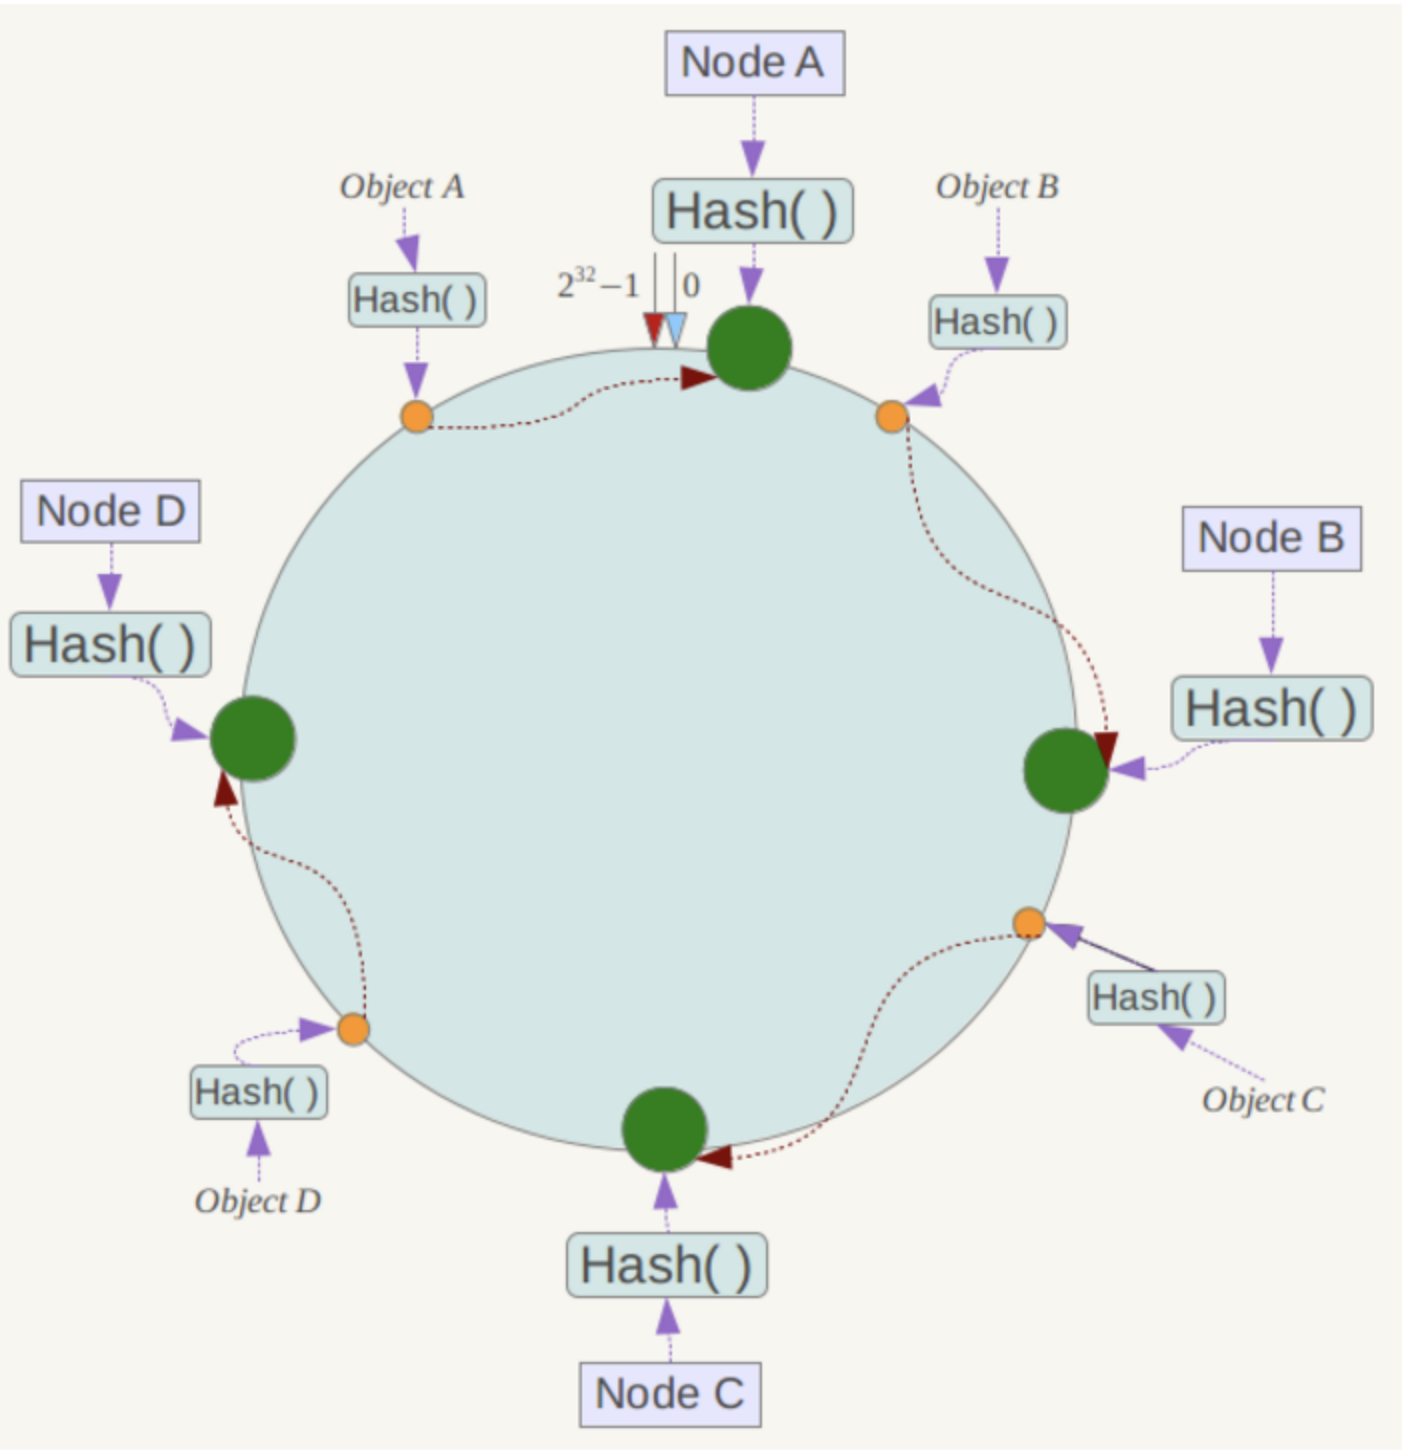
根据一致性哈希算法,数据 A 会被定为到 Node A 上,B 被定为到 Node B 上,C 被定为到 Node C 上,D 被定为到 Node D 上。
下面分析一致性哈希算法的容错性和可扩展性。现假设 Node C 不幸宕机,可以看到此时对象 A、B、D 不会受到影响,只有 C 对象被重定位到 Node D。一般的,在一致性哈希算法中,如果一台服务器不可用,则受影响的数据仅仅是此服务器到其环空间中前一台服务器(即沿着逆时针方向行走遇到的第一台服务器)之间数据,其它不会受到影响。
下面考虑另外一种情况,如果在系统中增加一台服务器 Node X,如下图所示:
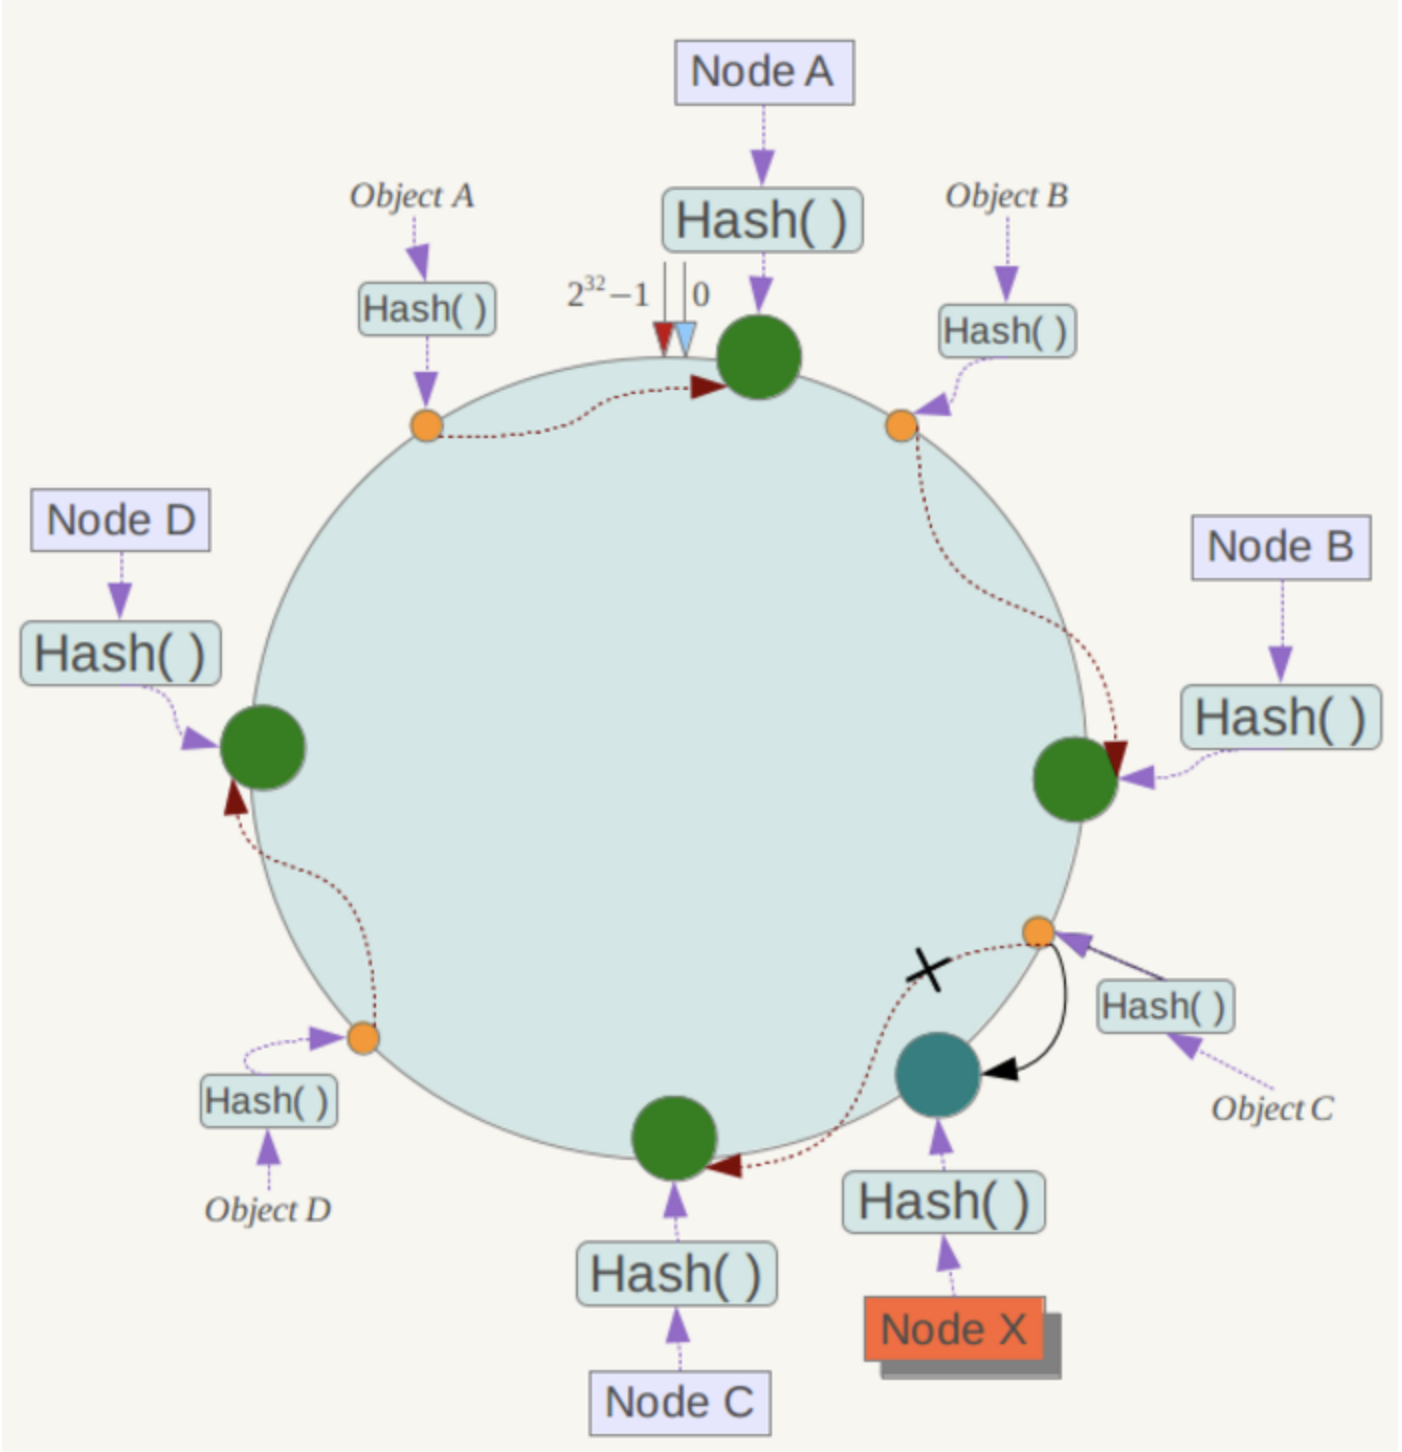
此时对象 Object A、B、D 不受影响,只有对象 C 需要重定位到新的 Node X 。一般的,在一致性哈希算法中,如果增加一台服务器,则受影响的数据仅仅是新服务器到其环空间中前一台服务器(即沿着逆时针方向行走遇到的第一台服务器)之间数据,其它数据也不会受到影响。
综上所述,一致性哈希算法对于节点的增减都只需重定位环空间中的一小部分数据,具有较好的容错性和可扩展性。
Java 代码实现
java
public class ConsistentHash<T> {

    /**
     * 节点的复制因子,实际节点个数 * numberOfReplicas = 虚拟节点个数
     */
    private final int numberOfReplicas;
    /**
     * 存储虚拟节点的hash值到真实节点的映射
     */
    private final SortedMap<Integer, T> circle = new TreeMap<Integer, T>();

    public ConsistentHash(int numberOfReplicas, Collection<T> nodes) {
        this.numberOfReplicas = numberOfReplicas;
        for (T node : nodes) {
            add(node);
        }
    }

    public void add(T node) {
        for (int i = 0; i < numberOfReplicas; i++) {
            // 对于一个实际机器节点 node, 对应 numberOfReplicas 个虚拟节点
            /*
             * 不同的虚拟节点(i不同)有不同的hash值,但都对应同一个实际机器node
             * 虚拟node一般是均衡分布在环上的,数据存储在顺时针方向的虚拟node上
             */
            String nodestr = node.toString() + i;
            int hashcode = nodestr.hashCode();
            System.out.println("hashcode:" + hashcode);
            circle.put(hashcode, node);

        }
    }

    public void remove(T node) {
        for (int i = 0; i < numberOfReplicas; i++) {
            circle.remove((node.toString() + i).hashCode());
        }
    }

    /**
     * 获得一个最近的顺时针节点,根据给定的key 取Hash
     * 然后再取得顺时针方向上最近的一个虚拟节点对应的实际节点
     * 再从实际节点中取得 数据
     *
     * @param key
     * @return
     */
    public T get(Object key) {
        if (circle.isEmpty()) {
            return null;
        }
        // node 用String来表示,获得node在哈希环中的hashCode
        int hash = key.hashCode();
        System.out.println("hashcode----->:" + hash);
        //数据映射在两台虚拟机器所在环之间,就需要按顺时针方向寻找机器
        if (!circle.containsKey(hash)) {
            SortedMap<Integer, T> tailMap = circle.tailMap(hash);
            hash = tailMap.isEmpty() ? circle.firstKey() : tailMap.firstKey();
        }
        return circle.get(hash);
    }

    public long getSize() {
        return circle.size();
    }

    /**
     * 查看表示整个哈希环中各个虚拟节点位置
     */
    public void testBalance() {
        //获得TreeMap中所有的Key
        Set<Integer> sets = circle.keySet();
        //将获得的Key集合排序
        SortedSet<Integer> sortedSets = new TreeSet<Integer>(sets);
        for (Integer hashCode : sortedSets) {
            System.out.println(hashCode);
        }

        System.out.println("----each location 's distance are follows: ----");
        /*
         * 查看相邻两个hashCode的差值
         */
        Iterator<Integer> it = sortedSets.iterator();
        Iterator<Integer> it2 = sortedSets.iterator();
        if (it2.hasNext()) {
            it2.next();
        }
        long keyPre, keyAfter;
        while (it.hasNext() && it2.hasNext()) {
            keyPre = it.next();
            keyAfter = it2.next();
            System.out.println(keyAfter - keyPre);
        }
    }

    public static void main(String[] args) {
        Set<String> nodes = new HashSet<String>();
        nodes.add("A");
        nodes.add("B");
        nodes.add("C");

        ConsistentHash<String> consistentHash = new ConsistentHash<String>(2, nodes);
        consistentHash.add("D");

        System.out.println("hash circle size: " + consistentHash.getSize());
        System.out.println("location of each node are follows: ");
        consistentHash.testBalance();

        String node = consistentHash.get("apple");
        System.out.println("node----------->:" + node);
    }

}高并发一致性问题
如何处理缓存与数据库不一致?****
什么情况下可能出现缓存和数据库中数据不一致呢?
- 数据库有数据,缓存没有数据;
- 数据库有数据,缓存也有数据,数据不相等;
- 数据库没有数据,缓存有数据。
看一个数据库有数据,缓存也有数据,数据不相等的场景:
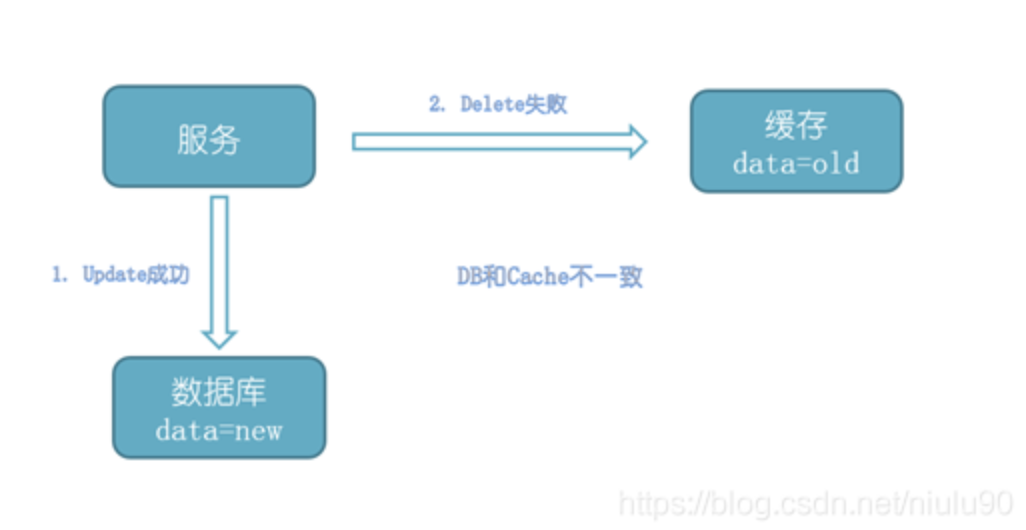
假设先写数据库,再淘汰缓存:第一步写数据库操作成功,第二步淘汰缓存失败,则会出现数据库中是新数据,缓存中是旧数据,数据不一致。
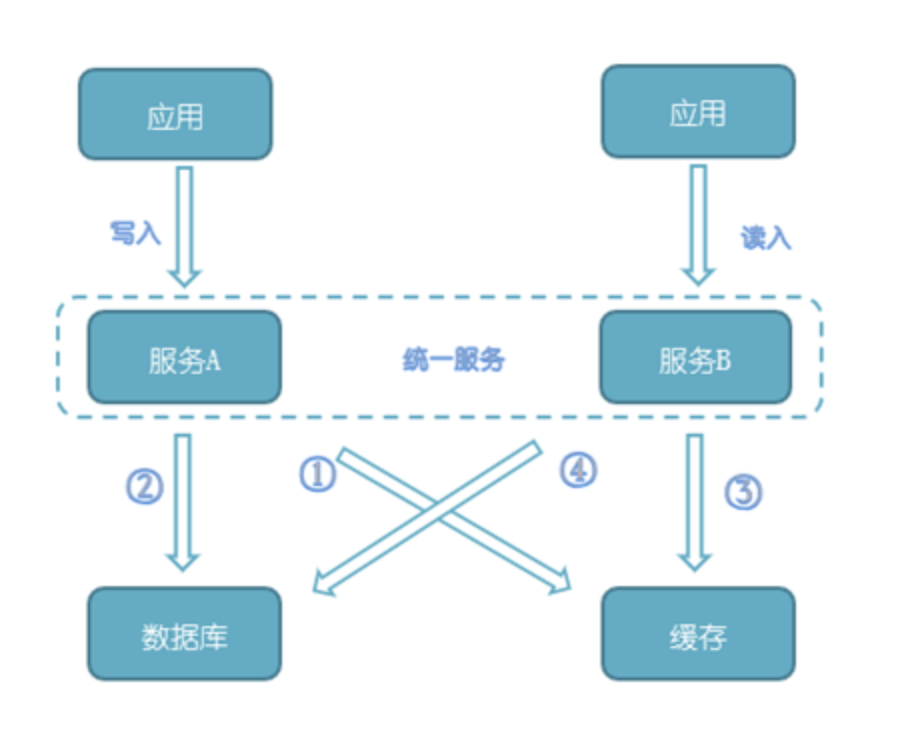
在分布式环境下,数据的读写都是并发的,上游有多个应用,通过一个服务的多个部署(为了保证可用性,一定是部署多份的),对同一个数据进行读写,在数据库层面并发的读写并不能保证完成顺序,也就是说后发出的读请求很可能先完成(读出脏数据):
(a)发生了写请求 A,A 的第一步淘汰了缓存 cache(如上图中的 1)
(b)A 的第二步写数据库,发出修改请求(如上图中的 2)
(c)发生了读请求 B,B 的第一步读取 cache,发现 cache 中是空的(如上图中的步骤 3)
(d)B 的第二步读取数据库,发出读取请求,此时A**** 的第二步写数据还没完成,读出了一个脏数据放入缓存 cache(如上图中的步骤 4)
即在数据库层面,后发出的请求 4 比先发出的请求 2 先完成了,读出了脏数据,脏数据又入了缓存,缓存与数据库中的数据不一致出现了
如何保证数据库与缓存的一致性
- 对删除缓存进行重试,数据的一致性要求越高,我越是重试得快。
- 定期全量更新,简单地说,就是我定期把缓存全部清掉,然后再全量加载。
- 对同一数据的读取/写入请求串行,保证同一数据的请求消息,都会路由到同一个服务上。一般来说,如果允许缓存可以稍微的跟数据库偶尔有不一致的情况,也就是说如果你的系统不是严格要求 “缓存 + 数据库” 必须保持一致性的话,最好不要做这个方案,即:读请求和写请求串行化,串到一个内存队列里去。串行化可以保证一定不会出现不一致的情况,但是它也会导致系统的吞吐量大幅度降低,用比正常情况下多几倍的机器去支撑线上的一个请求。
- 给所有的缓存一个失效期。
案例:mysql 与 redis 双写一致性问题分析
三个经典的缓存模式
- Cache-Aside Pattern 旁路缓存模式
- Read-Through/Write-through 读写穿透模式
- Write-behind 异步缓存写入
数据库主从不一致性怎么办?
大部分互联网的业务都是“读多写少”的场景,数据库层面,读性能往往成为瓶颈。业界通常采用“一主多从,读写分离,冗余多个读库”的数据库架构来提升数据库的读性能。
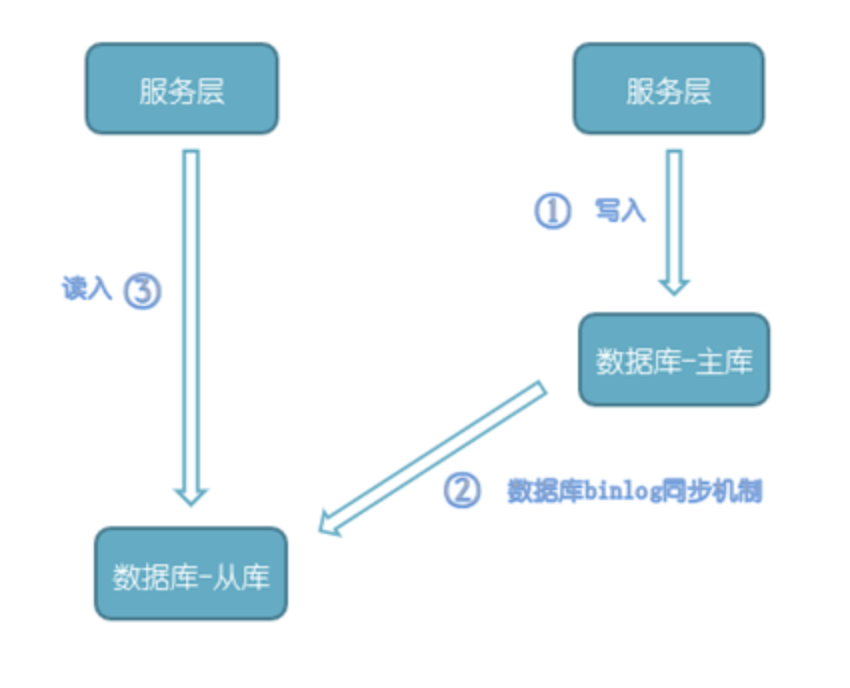
(1)系统先对 DB-master 进行了一个写操作,写主库
(2)很短的时间内并发进行了一个读操作,读从库,此时主从同步没有完成,故读取到了一个旧数据
(3)主从同步完成
数据库机制的强一致解决一致性
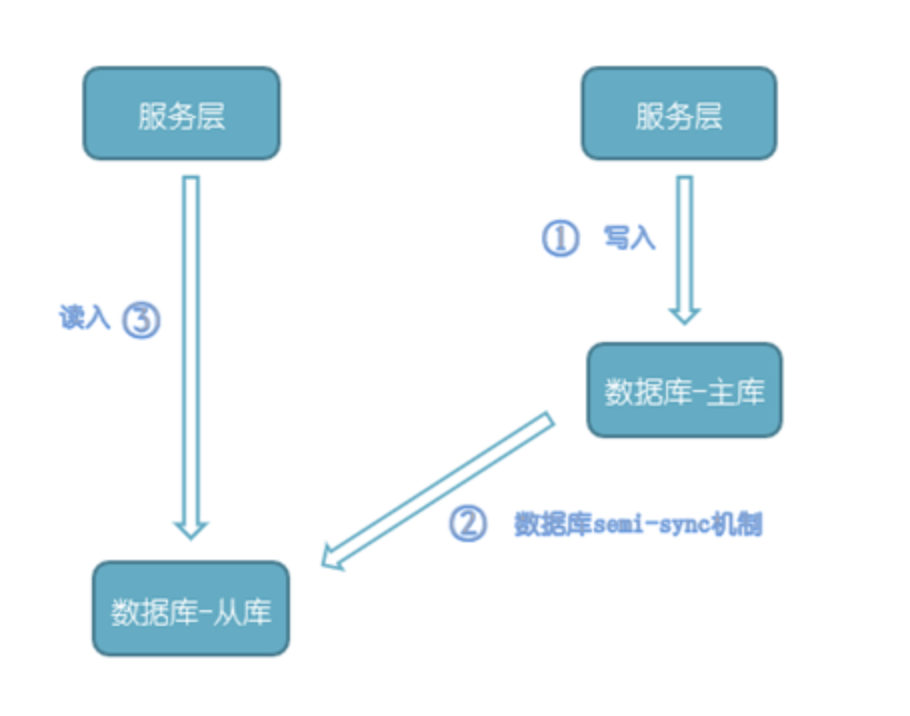
主从同步有一个时间差,假设是 1000ms,这个时间差,有读请求落到从库上**就会产生读从库的数据是旧数据**,有没有办法做到,等主从同步完成之后,主库上的写请求再返回呢?答案是肯定的,就是大家常说的“半同步复制”
(1)系统先对 DB-主库,进行了一个写操作,写主库
(2)等主从同步完成,写主库的请求才返回
(3)读从库,读到最新的数据(如果读请求先完成,写请求后完成,读取到的是“当时”最新的数据)
方案优点:利用数据库原生功能,比较简单
方案缺点:主库的写请求时延会增长,吞吐量会降低
强制读主库解决一致性
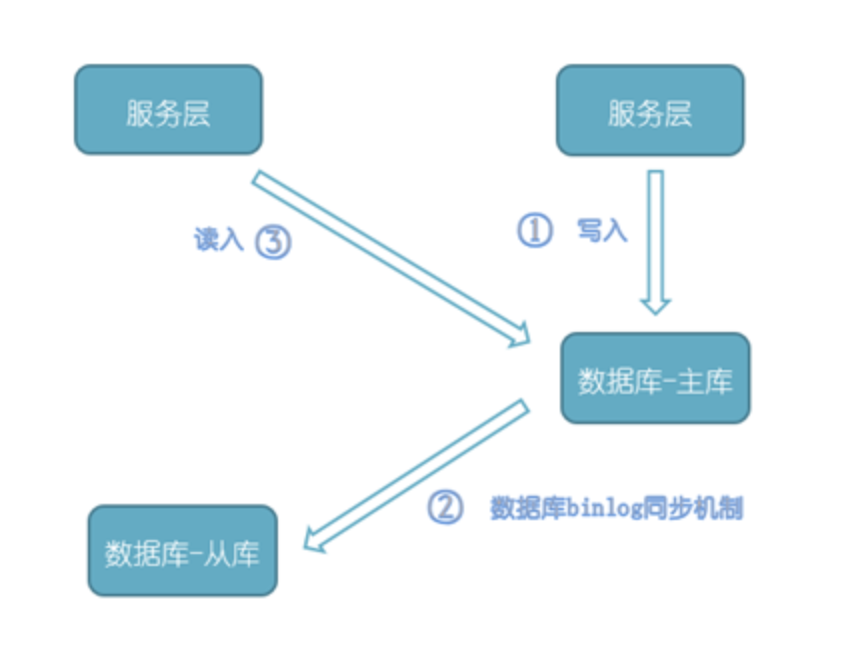
如果不使用“增加从库”的方式来增加提升系统的读性能,完全可以读写都落到主库,这样就不会出现不一致了:
方案优点:“一致性”上不需要进行系统改造
方案缺点:只能通过缓存来提升系统的读性能
数据库中间件解决一致性
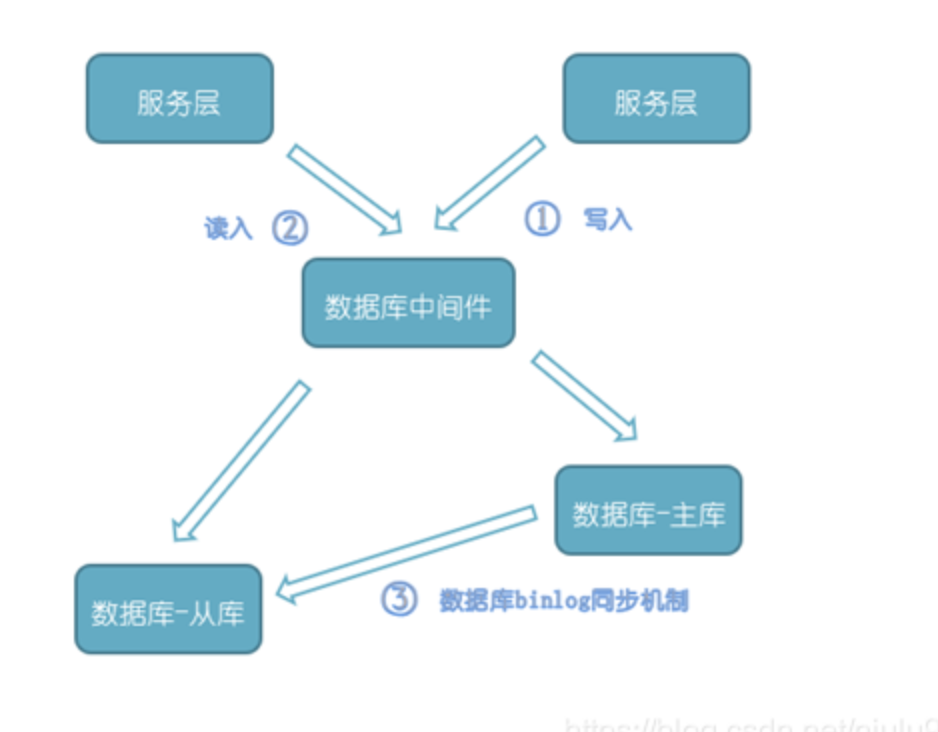
(1) 所有的读写都走数据库中间件,通常情况下,写请求路由到主库,读请求路由到从库
(2)记录所有路由到写库的 key,在经验主从同步时间窗口内(假设是 500ms),如果有读请求访问中间件,此 时有可能从库还是旧数据,就把这个 key 上的读请求路由到主库
(3)经验主从同步时间过完后,对应 key 的读请求继续路由到从库
方案优点:能保证绝对一致
方案缺点:数据库中间件的成本比较高
缓存解决一致性
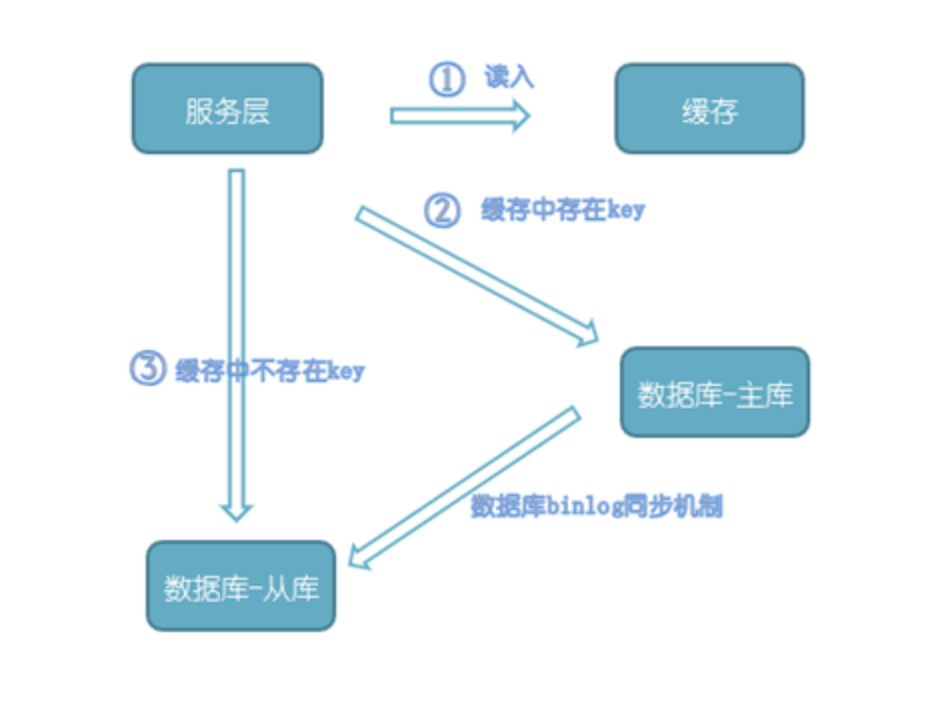
既然数据库中间件的成本比较高,有没有更低成本的方案来记录某一个库的某一个 key 上发生了写请求呢?很容易想到使用缓存,当写请求发生的时候:
- 将某个库上的某个 key 要发生写操作,记录在 cache 里
- 先到缓存中查看,对应库的对应 key 有没有相关数据
- 如果缓存中存在,相关数据,说明这个 key 上刚发生过写操作,此时需要将请求路由到主库读最新的数据
- 如果不存在,说明这个 key 上近期没有发生过写操作,此时将请求路由到从库,继续读写分离
方案优点:相对数据库中间件,成本较低
方案缺点:为了保证“一致性”,引入了一个 cache 组件,并且读写数据库时都多了一步 cache 操作
分布式系统 session 一致性问题
什么是 session 一致性问题?
只要用户不重启浏览器,每次 http 短连接请求,理论上服务端都能定位到 session,保持会话。
当只有一台 应用服务器 提供服务时,每次 http 短连接请求,都能够正确路由到存储 session 对应的应用服务器(因为只有一台),此时的应用服务器是无法保证高可用的。
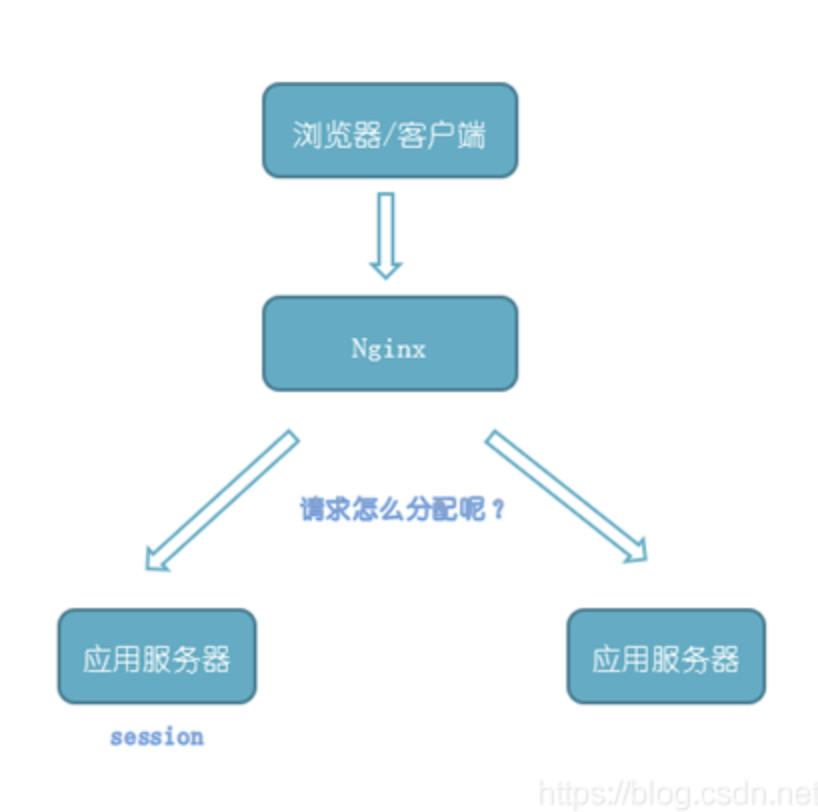
session 同步解决 session 一致性问题
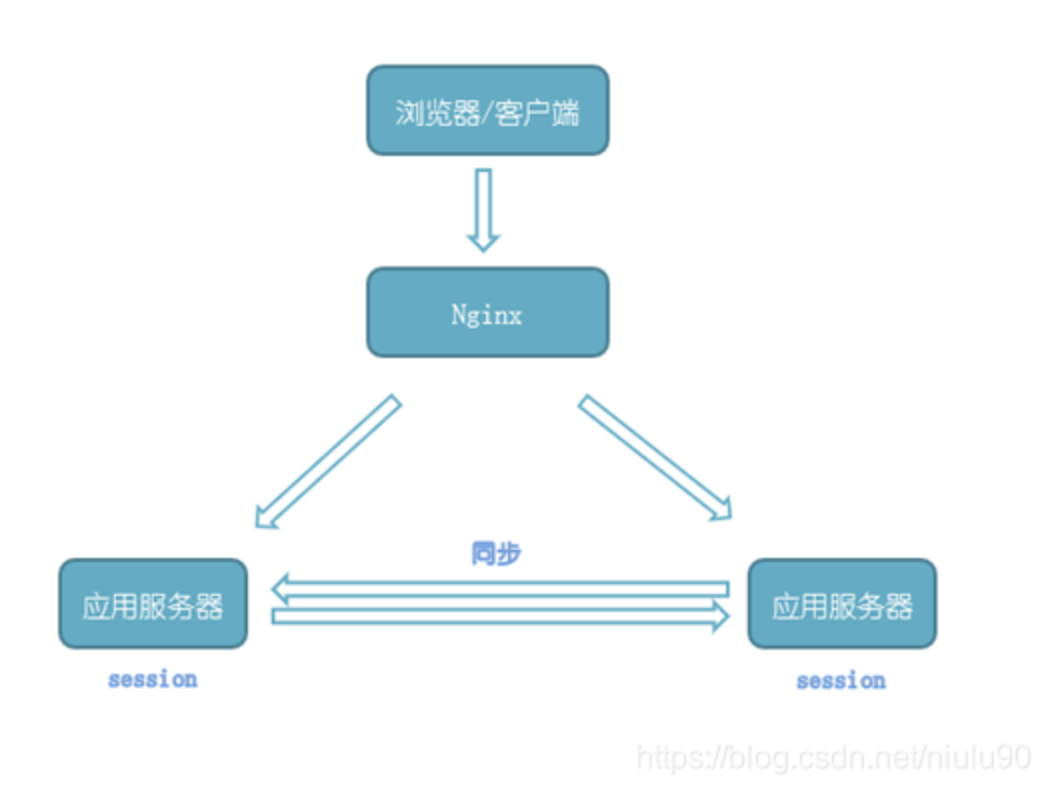
多个应用服务器之间相互同步 session,这样每个应用服务器之间都包含全部的 session
优点:应用服务器支持的功能,应用程序不需要修改代码
不足:
•session 的同步需要数据传输,占内网带宽,有时延
•所有应用服务器都包含所有 session 数据,数据量受内存限制,无法水平扩展
客户端存储解决 session 一致性问题
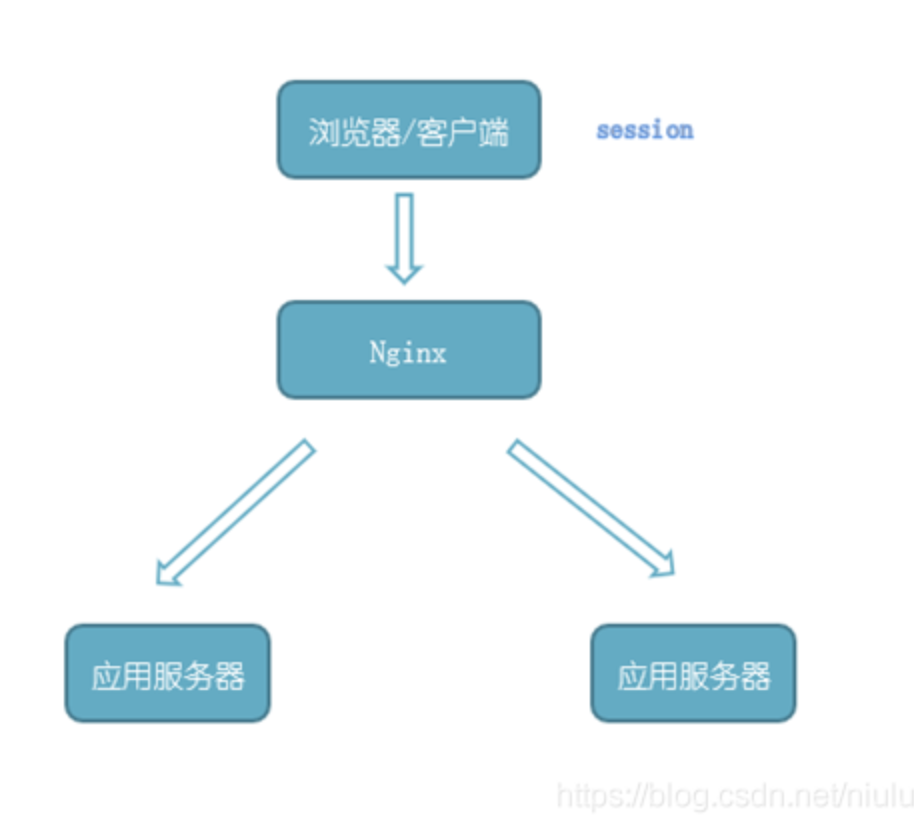
思路:服务端存储所有用户的 session,内存占用较大,可以将 session 存储到浏览器 cookie 中,每个端只要存储一个用户的数据了
优点:服务端不需要存储
缺点:
•每次 http 请求都携带 session,占外网带宽
•数据存储在端上,并在网络传输,存在泄漏、篡改、窃取等安全隐患
•session存储的数据大小受 cookie 限制
服务端存储解决 session 一致性问题
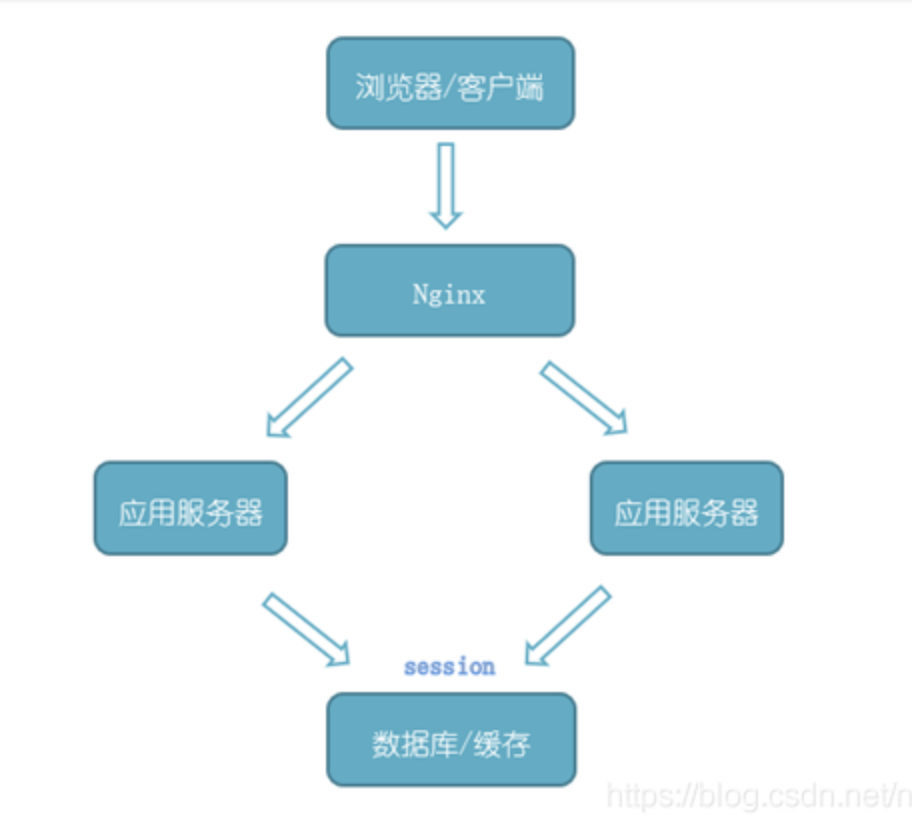
思路:将 session 存储在应用服务器后端的存储层,数据库或者缓存
优点:
•没有安全隐患
•可以水平扩展,数据库/缓存水平切分即可
•应用服务器重启或者扩容都不会有 session 丢失
不足:增加了一次网络调用,并且需要修改应用代码
Session 一致性总结
对于数据库存储还是缓存,个人推荐后者:session 读取的频率会很高,数据库压力会比较大。如果有 session 高可用需求,cache 可以做高可用,但大部分情况下 session 可以丢失,一般也不需要考虑高可用。
保证 session 一致性的架构设计常见方法:
•session同步法:多台应用服务器相互同步数据
•客户端存储法:一个用户只存储自己的数据
•后端统一存储:应用服务器重启和扩容,session 也不会丢失
分布式事务解决方案
两阶段提交(2PC)
两阶段提交 2PC 是分布式事务中最强大的事务类型之一,两段提交就是分两个阶段提交,第一阶段询问各个事务数据源是否准备好,第二阶段才真正将数据提交给事务数据源。
为了保证该事务可以满足 ACID,就要引入一个协调者(Cooradinator)。其他的节点被称为参与者(Participant)。协调者负责调度参与者的行为,并最终决定这些参与者是否要把事务进行提交。处理流程如下:
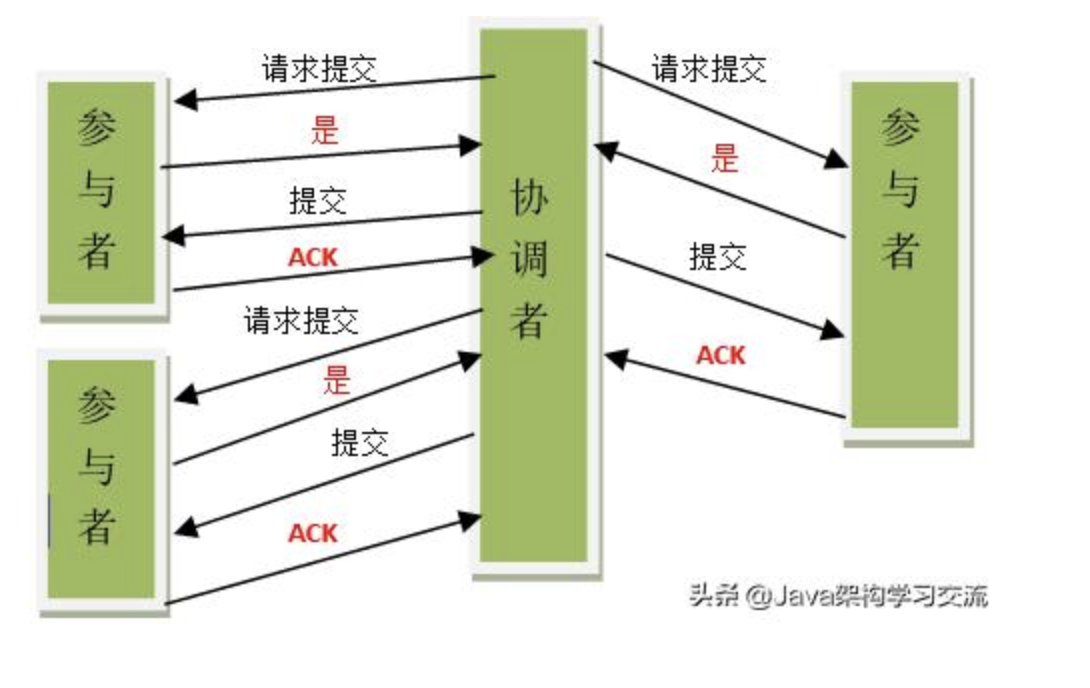
阶段一
a) 协调者向所有参与者发送事务内容,询问是否可以提交事务,并等待答复。
b) 各参与者执行事务操作,将 undo 和 redo 信息记入事务日志中(但不提交事务)。
c) 如参与者执行成功,给协调者反馈 yes,否则反馈 no。
阶段二
如果协调者收到了参与者的失败消息或者超时,直接给每个参与者发送回滚 (rollback) 消息;否则,发送提交 (commit) 消息。两种情况处理如下:
情况一
当所有参与者均反馈 yes,提交事务
a) 协调者向所有参与者发出正式提交事务的请求(即 commit 请求)。
b) 参与者执行 commit 请求,并释放整个事务期间占用的资源。
c) 各参与者向协调者反馈 ack(应答) 完成的消息。
d) 协调者收到所有参与者反馈的 ack 消息后,即完成事务提交。
情况二
当有一个参与者反馈 no,回滚事务
a) 协调者向所有参与者发出回滚请求(即 rollback 请求)。
b) 参与者使用阶段 1 中的 undo 信息执行回滚操作,并释放整个事务期间占用的资源。
c) 各参与者向协调者反馈 ack 完成的消息。
d) 协调者收到所有参与者反馈的 ack 消息后,即完成事务。
两阶段提交缺点
1) 性能问题:所有参与者在事务提交阶段处于同步阻塞状态,占用系统资源,容易导致性能瓶颈。
**2) 可靠性问题:** 如果协调者存在单点故障问题,或出现故障,提供者将一直处于锁定状态。
**3) 数据一致性问题:** 在阶段 2 中,如果出现协调者和参与者都挂了的情况,有可能导致数据不一致。
** 优点:** 尽量保证了数据的强一致,适合对数据强一致要求很高的关键领域。(其实也不能 100% 保证强一致)。
** 缺点:** 实现复杂,牺牲了可用性,对性能影响较大,不适合高并发高性能场景。
三阶段提交(3PC)
三阶段提交是在二阶段提交上的改进版本,3PC 最关键要解决的就是协调者和参与者同时挂掉的问题,所以 3PC 把 2PC 的准备阶段再次一分为二,这样三阶段提交。处理流程如下:
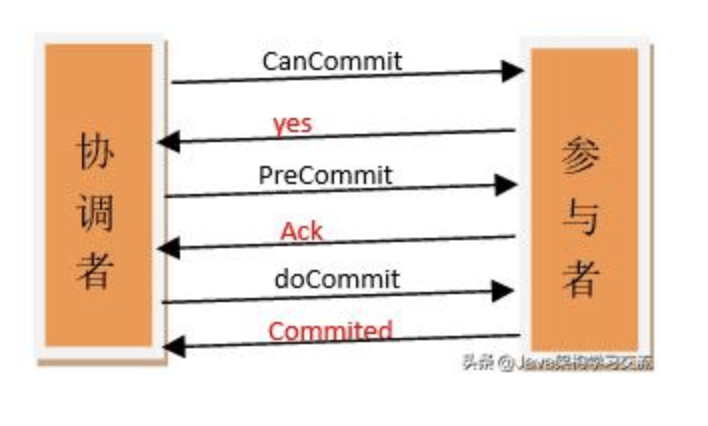
阶段一
a) 协调者向所有参与者发出包含事务内容的 canCommit 请求,询问是否可以提交事务,并等待所有参与者答复。
b) 参与者收到 canCommit 请求后,如果认为可以执行事务操作,则反馈 yes 并进入预备状态,否则反馈 no。
阶段二
协调者根据参与者响应情况,有以下两种可能。
情况一
所有参与者均反馈 yes,协调者预执行事务
a) 协调者向所有参与者发出 preCommit 请求,进入准备阶段。
b) 参与者收到 preCommit 请求后,执行事务操作,将 undo 和 redo 信息记入事务日志中(但不提交事务)。
c) 各参与者向协调者反馈 ack 响应或 no 响应,并等待最终指令。
情况二
只要有一个参与者反馈 no,或者等待超时后协调者尚无法收到所有提供者的反馈,即中断事务
a) 协调者向所有参与者发出 abort 请求。
b) 无论收到协调者发出的 abort 请求,或者在等待协调者请求过程中出现超时,参与者均会中断事务。
阶段三
该阶段进行真正的事务提交,也可以分为以下两种情况。
阶段三情况一
所有参与者均反馈 ack 响应,执行真正的事务提交
a) 如果协调者处于工作状态,则向所有参与者发出 do Commit 请求。
b) 参与者收到 do Commit 请求后,会正式执行事务提交,并释放整个事务期间占用的资源。
c) 各参与者向协调者反馈 ack 完成的消息。
d) 协调者收到所有参与者反馈的 ack 消息后,即完成事务提交。
阶段三情况二
只要有一个参与者反馈 no,或者等待超时后协调组尚无法收到所有提供者的反馈,即回滚事务。
a) 如果协调者处于工作状态,向所有参与者发出 rollback 请求。
b) 参与者使用阶段 1 中的 undo 信息执行回滚操作,并释放整个事务期间占用的资源。
c) 各参与者向协调组反馈 ack 完成的消息。
d) 协调组收到所有参与者反馈的 ack 消息后,即完成事务回滚。
** 优点:** 相比二阶段提交,三阶段提交降低了阻塞范围,在等待超时后协调者或参与者会中断事务。避免了协调者单点问题。阶段 3 中协调者出现问题时,参与者会继续提交事务。
** 缺点:** 数据不一致问题依然存在,当在参与者收到 preCommit 请求后等待 do commite 指令时,此时如果协调者请求中断事务,而协调者无法与参与者正常通信,会导致参与者继续提交事务,造成数据不一致。
补偿事务(TCC)
TCC 是服务化的二阶段编程模型,采用的补偿机制:
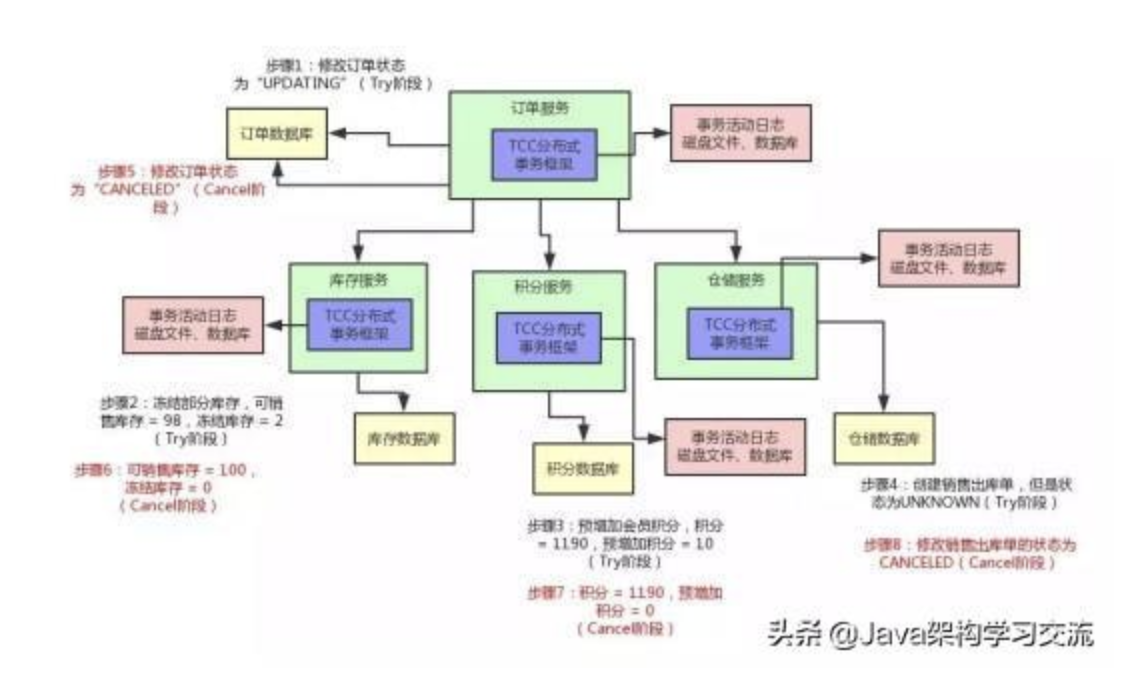
条件:
需要实现确认和补偿逻辑
需要支持幂等
处理流程
a) Try 阶段主要是对业务系统做检测及资源预留。
这个阶段主要完成:
完成所有业务检查 ( 一致性 ) 。
预留必须业务资源 ( 准隔离性 ) 。
Try 尝试执行业务。
b) Confirm 阶段主要是对业务系统做确认提交。
Try 阶段执行成功并开始执行 Confirm 阶段时,默认 Confirm 阶段是不会出错的。即:只要 Try 成功,Confirm 一定成功。
c) Cancel 阶段主要是在业务执行错误,需要回滚的状态下执行的业务取消,预留资源释放。
优点:
性能提升:具体业务来实现控制资源锁的粒度变小,不会锁定整个资源。
数据最终一致性:基于 Confirm 和 Cancel 的幂等性,保证事务最终完成确认或者取消,保证数据的一致性。
可靠性:解决了 XA 协议的协调者单点故障问题,由主业务方发起并控制整个业务活动,业务活动管理器也变成多点,引入集群。
** 缺点:**TCC 的 Try、Confirm 和 Cancel 操作功能要按具体业务来实现,业务耦合度较高,提高了开发成本。
可靠消息
支持事务消息的 MQ,其支持事务消息的方式采用类似于二阶段提交。
基于 MQ 的分布式事务方案其实是对本地消息表的封装,将本地消息表基于 MQ 内部,其他方面的协议基本与本地消息表一致。
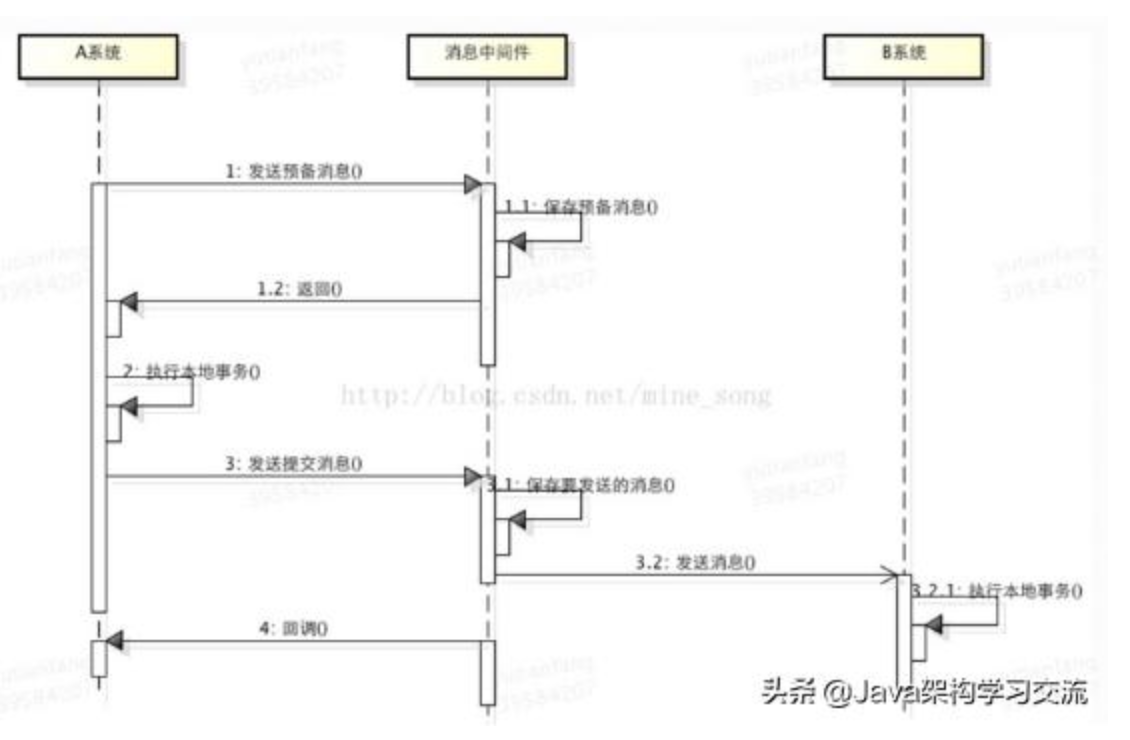
条件:
a) 需要补偿逻辑
b) 业务处理逻辑需要幂等
处理流程
c) 消费者向 MQ 发送 half 消息。
d) MQ Server 将消息持久化后,向发送方 ack 确认消息发送成功。
e) 消费者开始执行事务逻辑。
f) 消费者根据本地事务执行结果向 MQ Server 提交二次确认或者回滚。
g) MQ Server 收到 commit 状态则将 half 消息标记可投递状态。
h) 服务提供者收到该消息,执行本地业务逻辑。返回处理结果。
优点:
消息数据独立存储,降低业务系统与消息系统之间的耦合。
吞吐量优于本地消息表方案。
缺点:
一次消息发送需要两次网络请求 (half 消息 + commit/rollback)。
需要实现消息回查接口。
Sagas 事务模型(最终一致性)
Saga 模式是一种分布式异步事务,一种最终一致性事务,是一种柔性事务,有两种不同的方式来实现 saga 事务,最流行的两种方式是:
事件/编排 Choreography
没有中央协调器(没有单点风险)时,每个服务产生并聆听其他服务的事件,并决定是否应采取行动。
该实现第一个服务执行一个事务,然后发布一个事件。该事件被一个或多个服务进行监听,这些服务再执行本地事务并发布(或不发布)新的事件,当最后一个服务执行本地事务并且不发布任何事件时,意味着分布式事务结束,或者它发布的事件没有被任何 Saga 参与者听到都意味着事务结束。
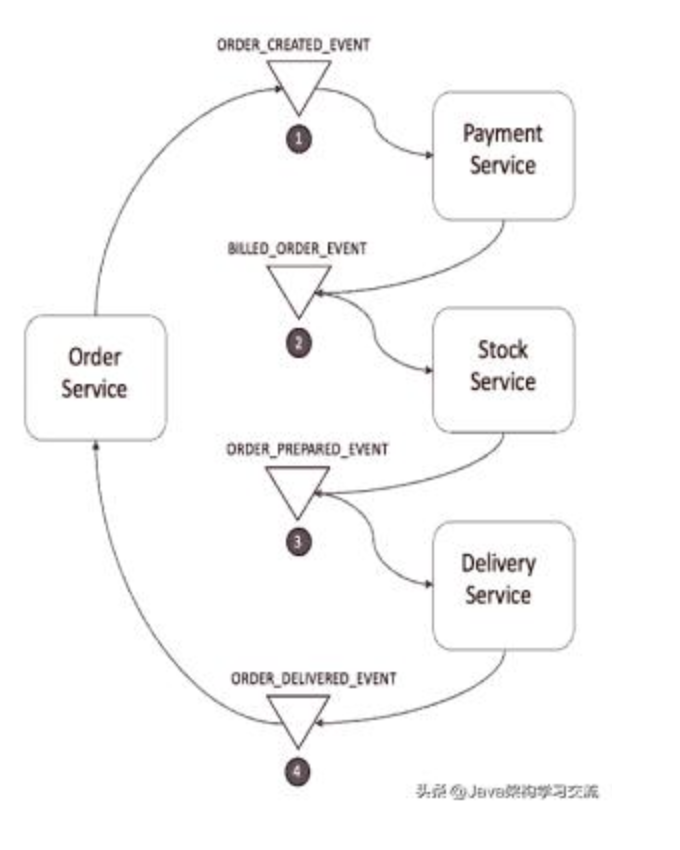
处理流程:
订单服务保存新订单,将状态设置为 pengding 挂起状态,并发布名为 ORDER_CREATED_EVENT 的事件。
支付服务监听 ORDER_CREATED_EVENT,并公布事件 BILLED_ORDER_EVENT。
库存服务监听 BILLED_ORDER_EVENT,更新库存,并发布 ORDER_PREPARED_EVENT。
货运服务监听 ORDER_PREPARED_EVENT,然后交付产品。最后,它发布 ORDER_DELIVERED_EVENT。
最后,订单服务侦听 ORDER_DELIVERED_EVENT 并设置订单的状态为 concluded 完成。
假设库存服务在事务过程中失败了。进行回滚:
库存服务产生 PRODUCT_OUT_OF_STOCK_EVENT
订购服务和支付服务会监听到上面库存服务的这一事件:
①支付服务会退款给客户。
②订单服务将订单状态设置为失败。
** 优点:** 事件/编排是实现 Saga 模式的自然方式; 它很简单,容易理解,不需要太多的努力来构建,所有参与者都是松散耦合的,因为他们彼此之间没有直接的耦合。如果您的事务涉及 2 至 4 个步骤,则可能是非常合适的。
命令/协调 orchestrator:
中央协调器负责集中处理事件的决策和业务逻辑排序。
saga 协调器 orchestrator 以命令/回复的方式与每项服务进行通信,告诉他们应该执行哪些操作。
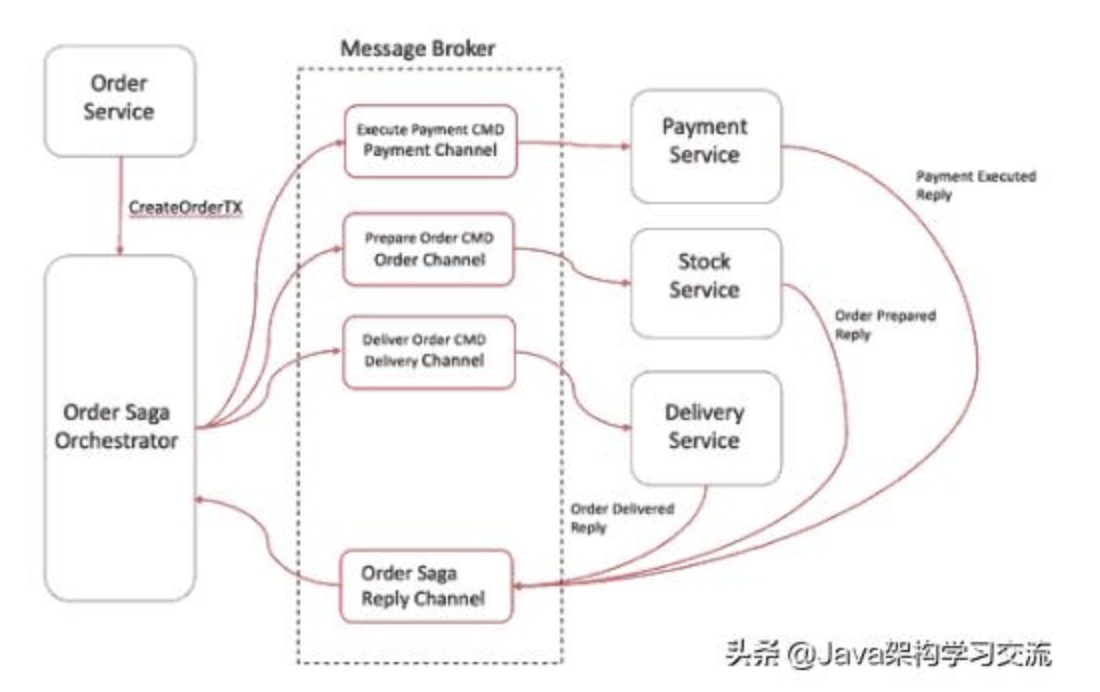
订单服务保存 pending 状态,并要求订单 Saga 协调器(简称 OSO)开始启动订单事务。
OSO 向收款服务发送执行收款命令,收款服务回复 Payment Executed 消息。
OSO 向库存服务发送准备订单命令,库存服务将回复 OrderPrepared 消息。
OSO 向货运服务发送订单发货命令,货运服务将回复 Order Delivered 消息。
OSO 订单 Saga 协调器必须事先知道执行“创建订单”事务所需的流程 (通过读取 BPM 业务流程 XML 配置获得)。如果有任何失败,它还负责通过向每个参与者发送命令来撤销之前的操作来协调分布式的回滚。当你有一个中央协调器协调一切时,回滚要容易得多,因为协调器默认是执行正向流程,回滚时只要执行反向流程即可。
优点:
避免服务之间的循环依赖关系,因为 saga 协调器会调用 saga 参与者,但参与者不会调用协调器。
集中分布式事务的编排。
只需要执行命令/回复 (其实回复消息也是一种事件消息),降低参与者的复杂性。
在添加新步骤时,事务复杂性保持线性,回滚更容易管理。
如果在第一笔交易还没有执行完,想改变有第二笔事务的目标对象,则可以轻松地将其暂停在协调器上,直到第一笔交易结束。